VSCode Plugin
O plugin TOTVS Carol para o Visual Studio Code permite a construção e teste de Pipelines com recursos como code completion, testes dry-run da pipeline e execução da pipeline SQL na Carol. O plugin pode ser executado em outras IDEs similares, como Cursor. Para isso, basta solicitar o arquivo VSIX para o time IDEIA via issue.
O plugin traz o Carol MCP Server, que conecta o GitHub Copilot à sua tenant. Com ele, o Copilot consulta suas staging tables e data models, lê esta documentação e valida a query com dry run, para escrever e depurar pipelines com base nos campos reais da sua tenant. Veja como usar em Desenvolvimento com Copilot.
Instalação
→ Para conhecer os passos de instalação acesse a página oficial do plugin TOTVS Carol.
Após instalado, o plugin pode ser acessado no menu lateral esquerdo do VSCode.
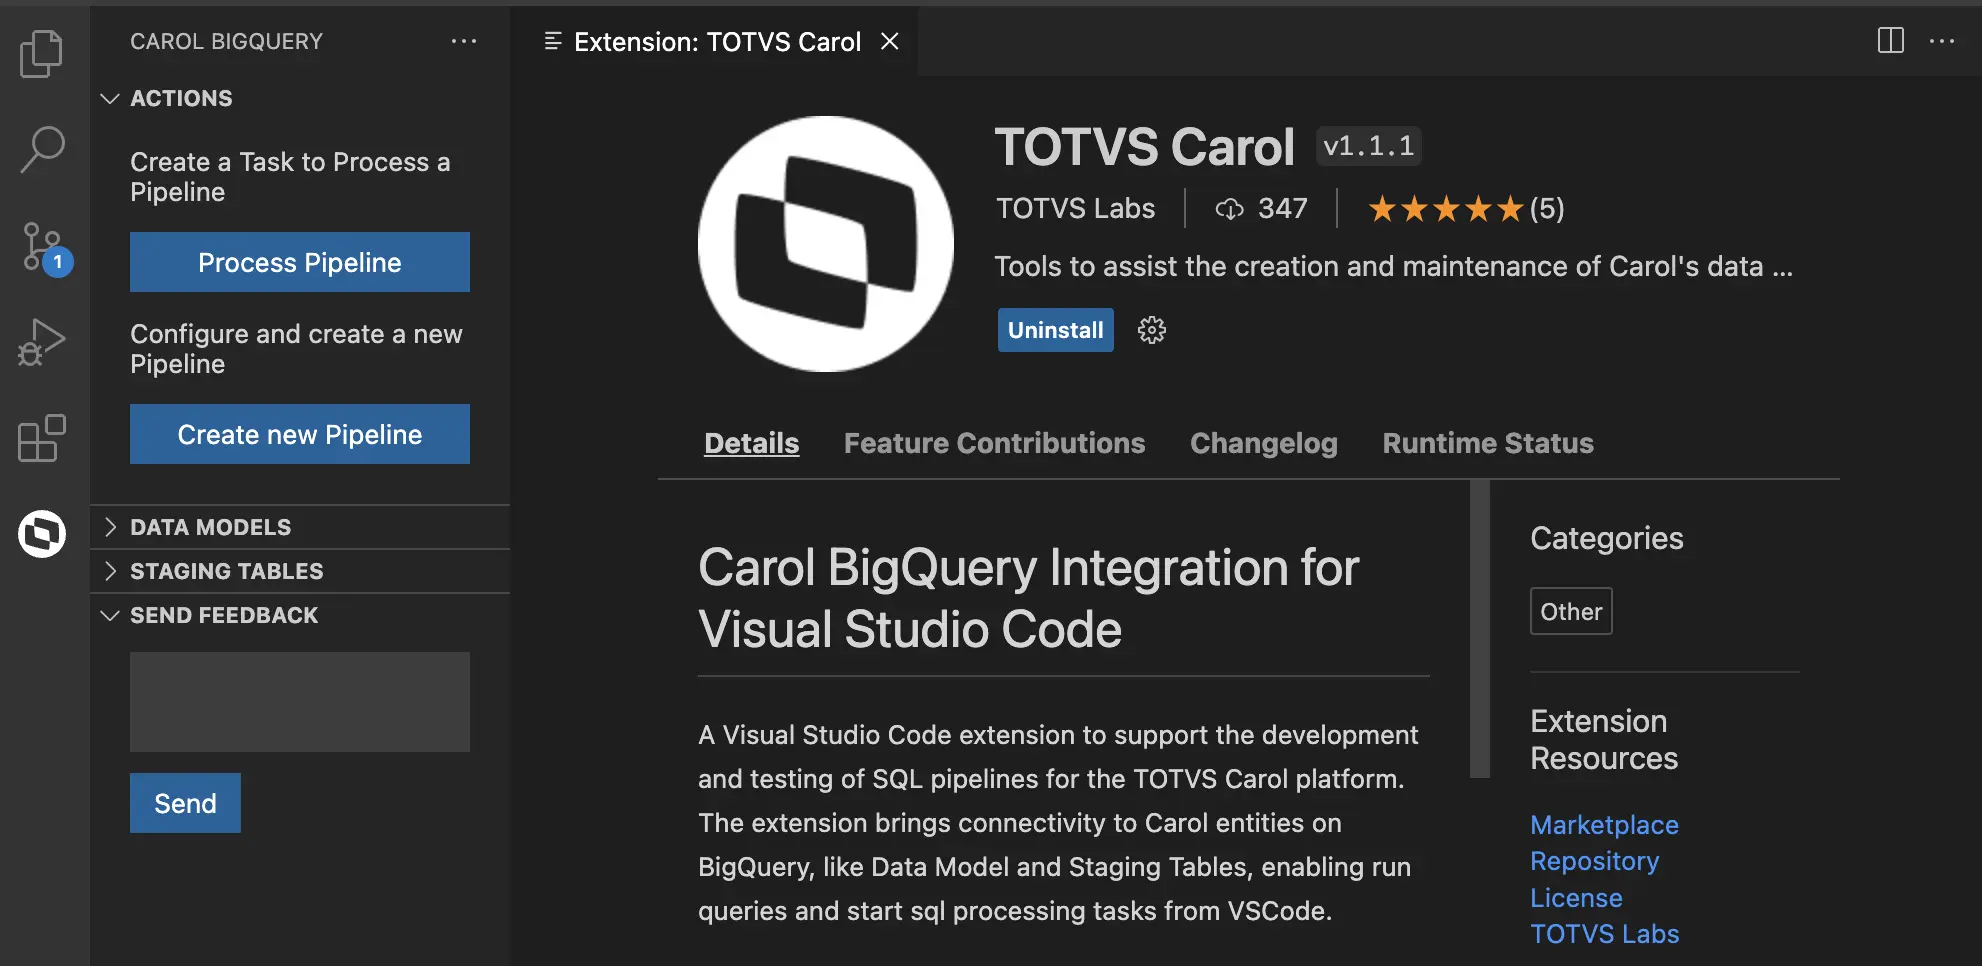
Para gerenciar as Tenants e realizar outras ações, use o atalho (Ctrl + Shift + P) e digite "Carol".
Para fazer login, você deverá informar a Organização, e será redirecionado para o login na Carol. Após o login será possível selecionar as Tenants que serão ativadas, e o plugin estará pronto para uso, permitindo processar e criar novas pipelines, entre outras operações listadas abaixo.
Para melhor uso do plugin do VSCode, os arquivos pipeline deve ser definidos com extensão csql.
Operações
O plugin do VSCode permite as seguintes operações:

Algumas operações podem ser acionadas diretamente ao abrir arquivos csql, no canto superior direito.
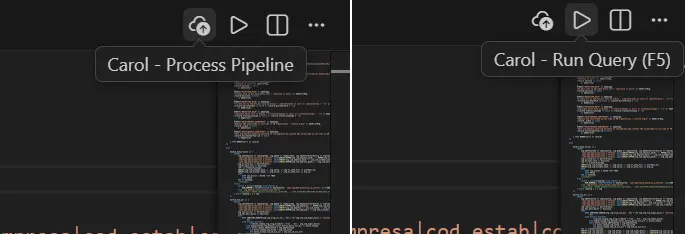
Os comandos do VSCode possuem o seguinte objetivo:
Carol - Login
O plugin solicitará os dados para adicionar uma Tenant dentro do VSCode, permitindo a interação com a Carol através de uma conexão já estabelecida. Internamente, o plugin irá criar o connector token no ambiente informado.
Carol - Tenants
Este comando permite listar todas as Tenants disponíveis no plugin permitindo ativar uma Tenant ou deletar uma Tenant.
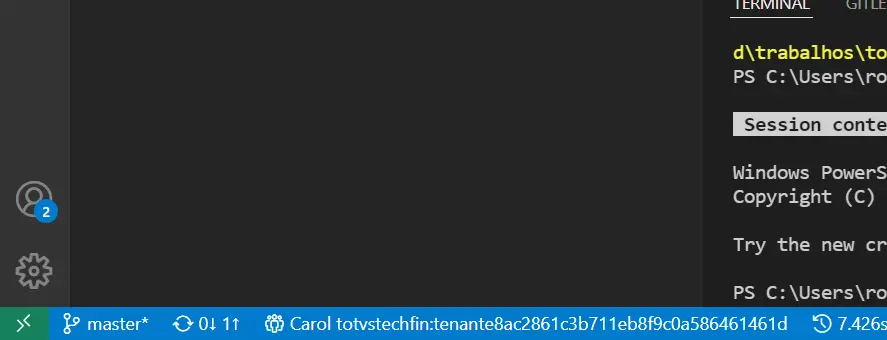
Uma vez que a Tenant está ativa, a informação da Tenant ficará disponível no rodapé do VSCode:
Carol: Refresh Staging Tables
Este comando permite atualizar em tela a lista de staging tables da tenant ativa.
Carol: Refresh Data Models
Este comando permite atualizar em tela a lista de data models da tenant ativa.
Carol - Dry Run Query
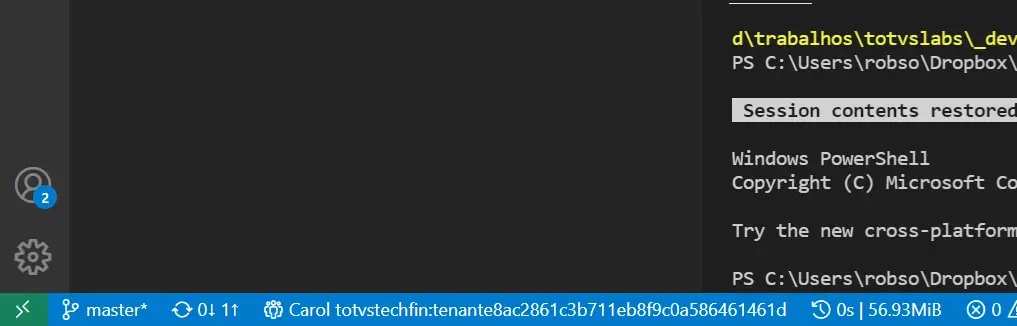
O comando dry-run submete a query para o dry-run do Bigquery, retornando a quantidade estimada de megabytes que será lido. Este comando é ideal para validar recursos necessários para execução da query.
O resultado é observado no rodapé do VSCode, ao lado do ambiente conectado.
Carol - Run Query
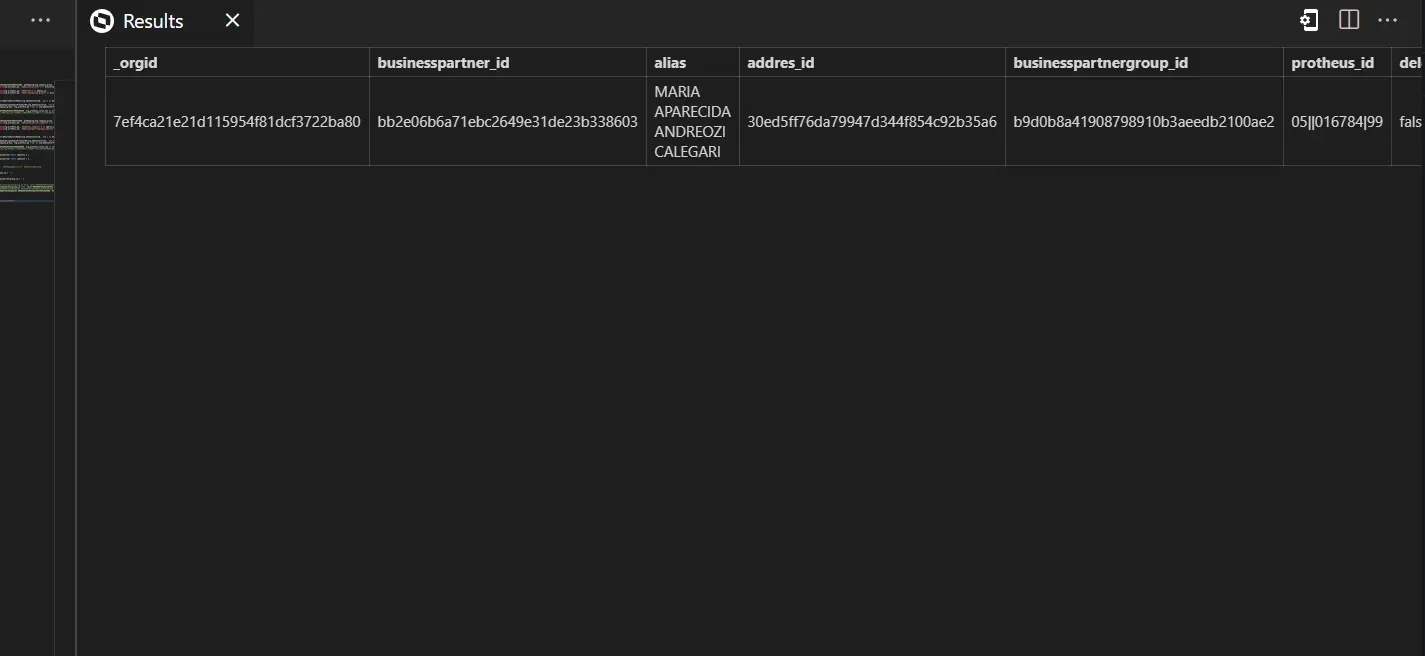
Este comando permite executar uma query para validar o resultado da pipeline. Um atalho para esse comando é a tecla F5, que vai submeter a query ao ambiente conectado (visível no rodapé) e vai mostrar o resultado numa panel nova.
Este comando não valida o schema retornado pela pipeline contra o schema do Data Model.
Carol: Create Pipeline
Este comando permite criar uma pipeline que será posteriormente utilizada por um manifesto ou que poderá ser executada diretamente pelo comando Carol - Process Pipeline.
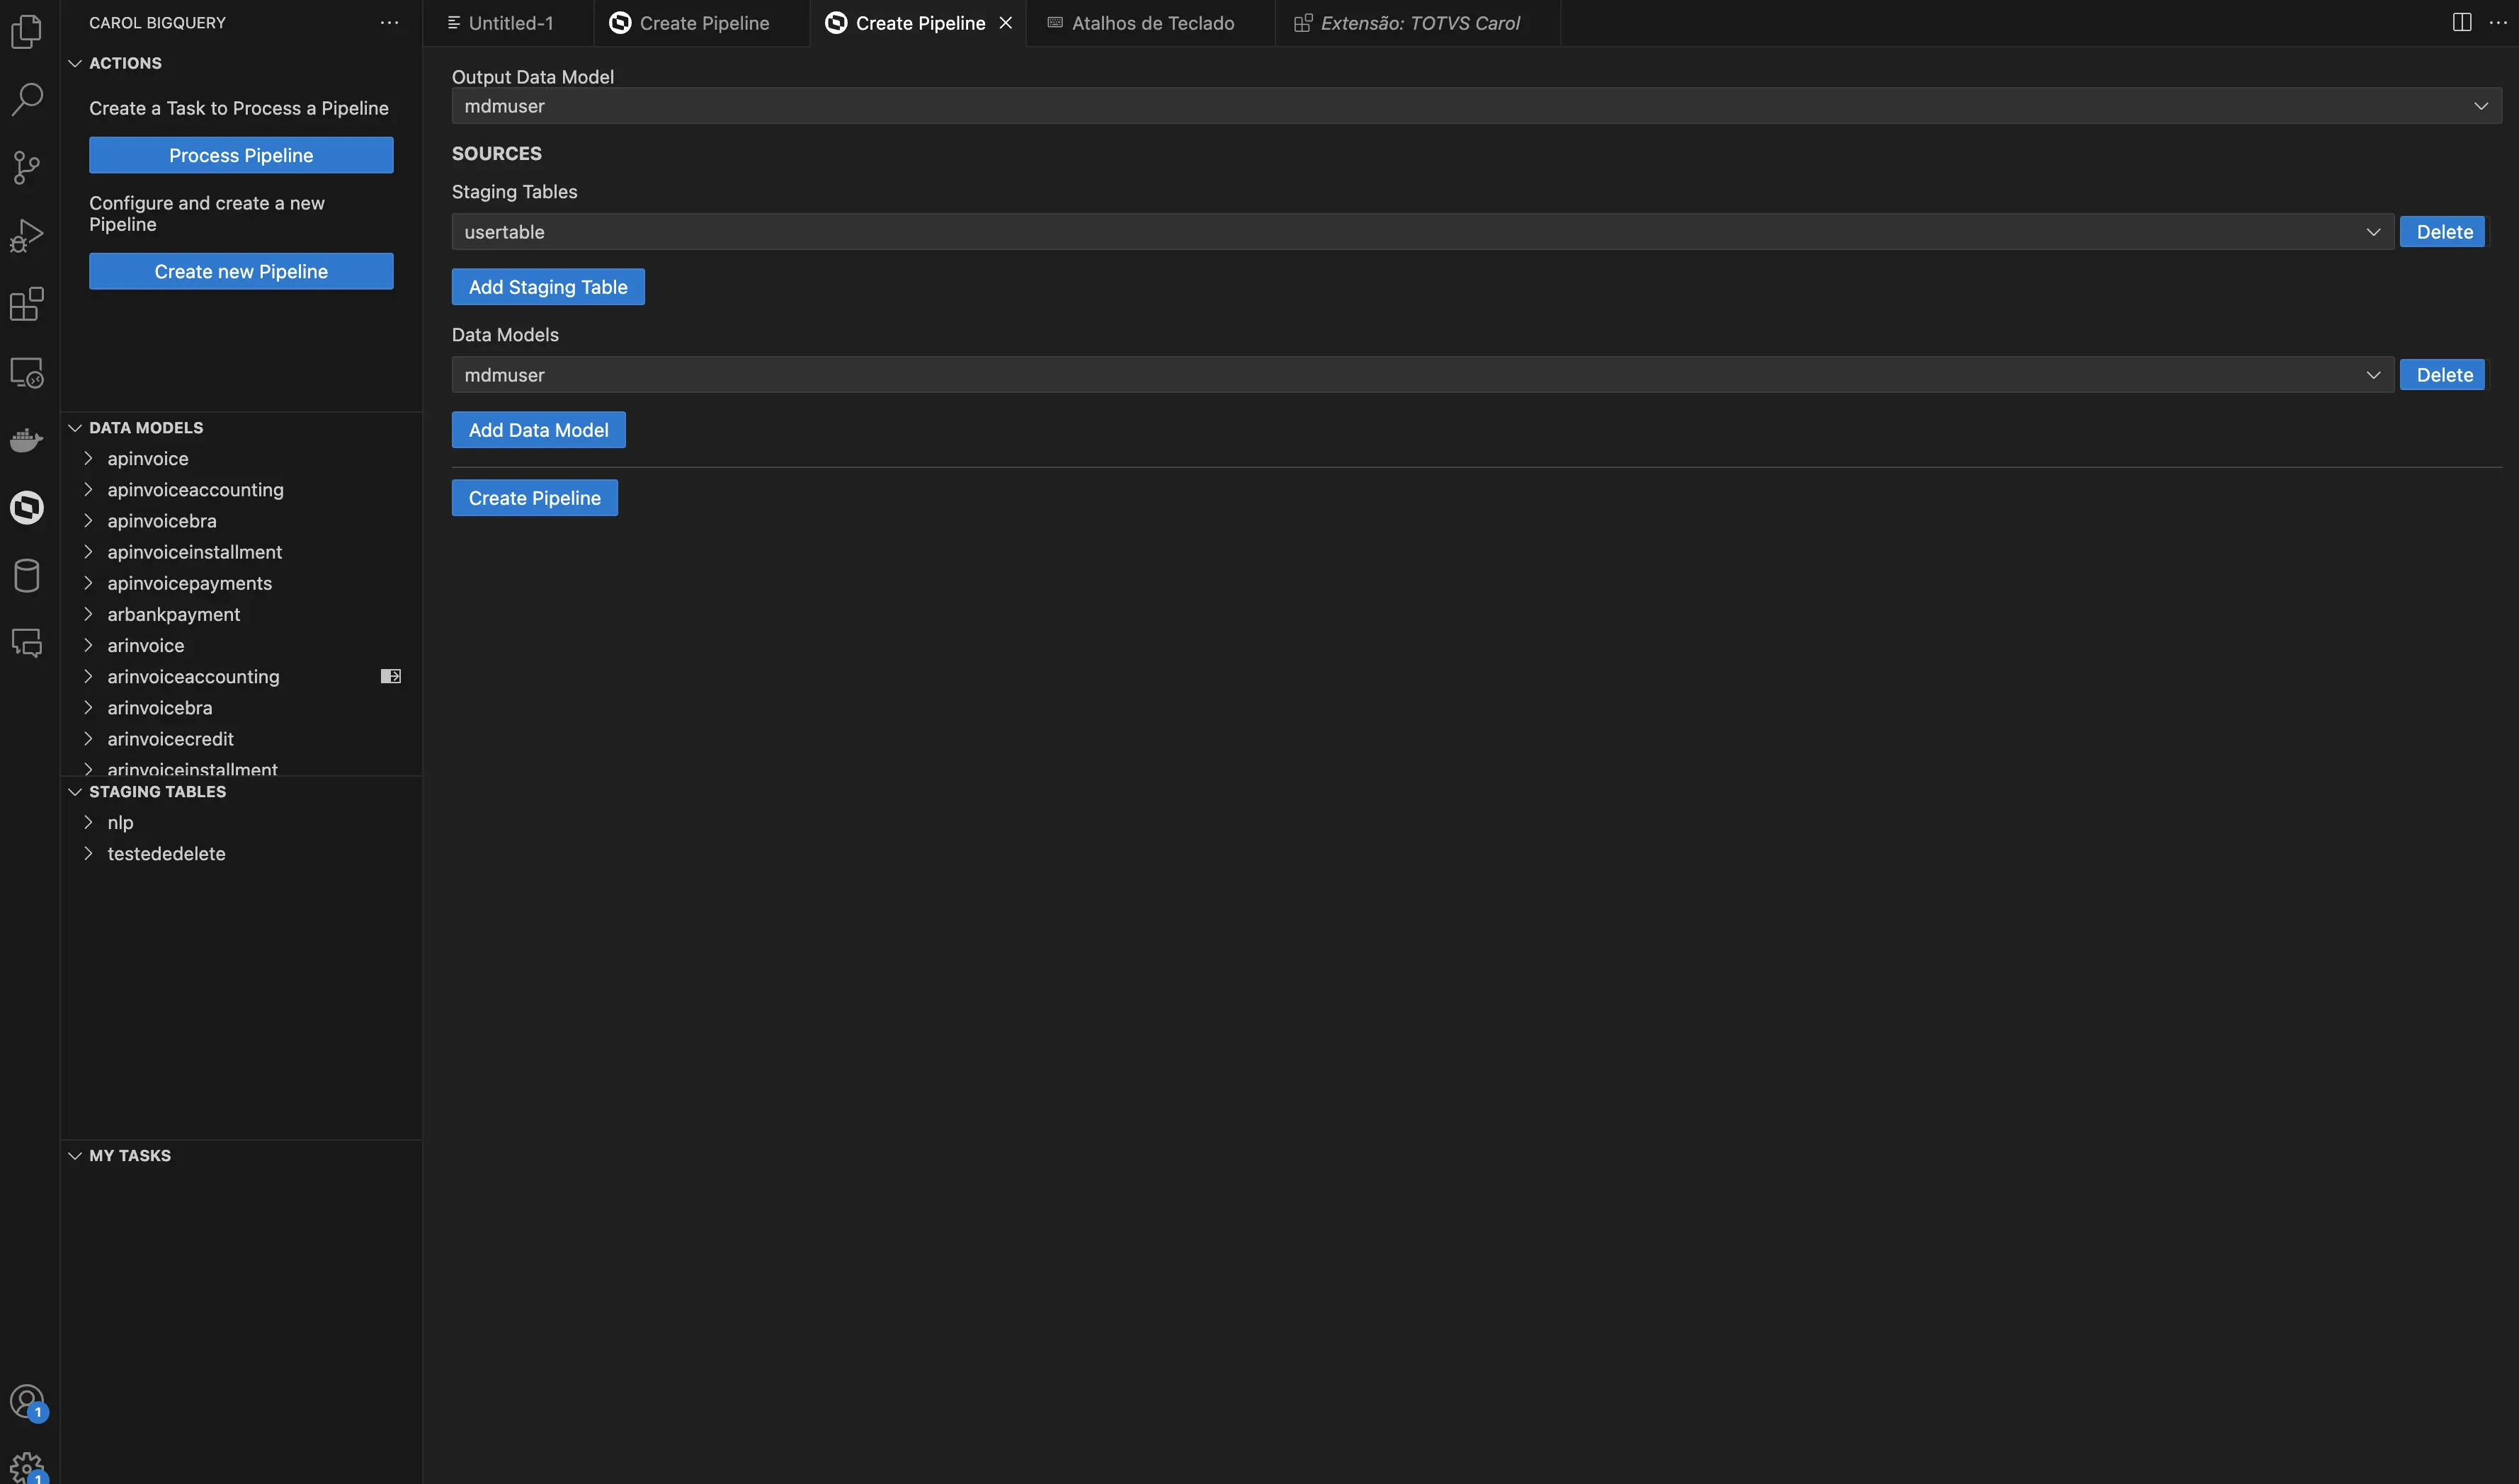
Os parâmetros disponíveis:
Output Data Model:SOURCES: agrupador indicando as origens dos dados a serem processados.Staging Tables: indica quais tabelas com registros brutos serão utilizadas no processamento. As tabelas podem ser adicionadas ou removidas, por meio do botão disponível.Data Models: indica quais tabelas com registros já processados serão reutilizadas no processamento. As tabelas podem ser adicionadas ou removidas, por meio do botão disponível.
Quando o botão Create Pipeline é acionado, será criada a partir dos parâmetros informados, a estrutura base da pipeline facilitando o processo posterior de configuração pelo desenvolvedor.
Carol: Process Pipeline
Este comando permite processar os dados na Carol executando a pipeline diretamente na Carol. O comando permite alterar uma série de parâmetros para determinar aonde o dado processado será armazenado, quando executado esse comando será criado uma task na Carol para acompanhamento.
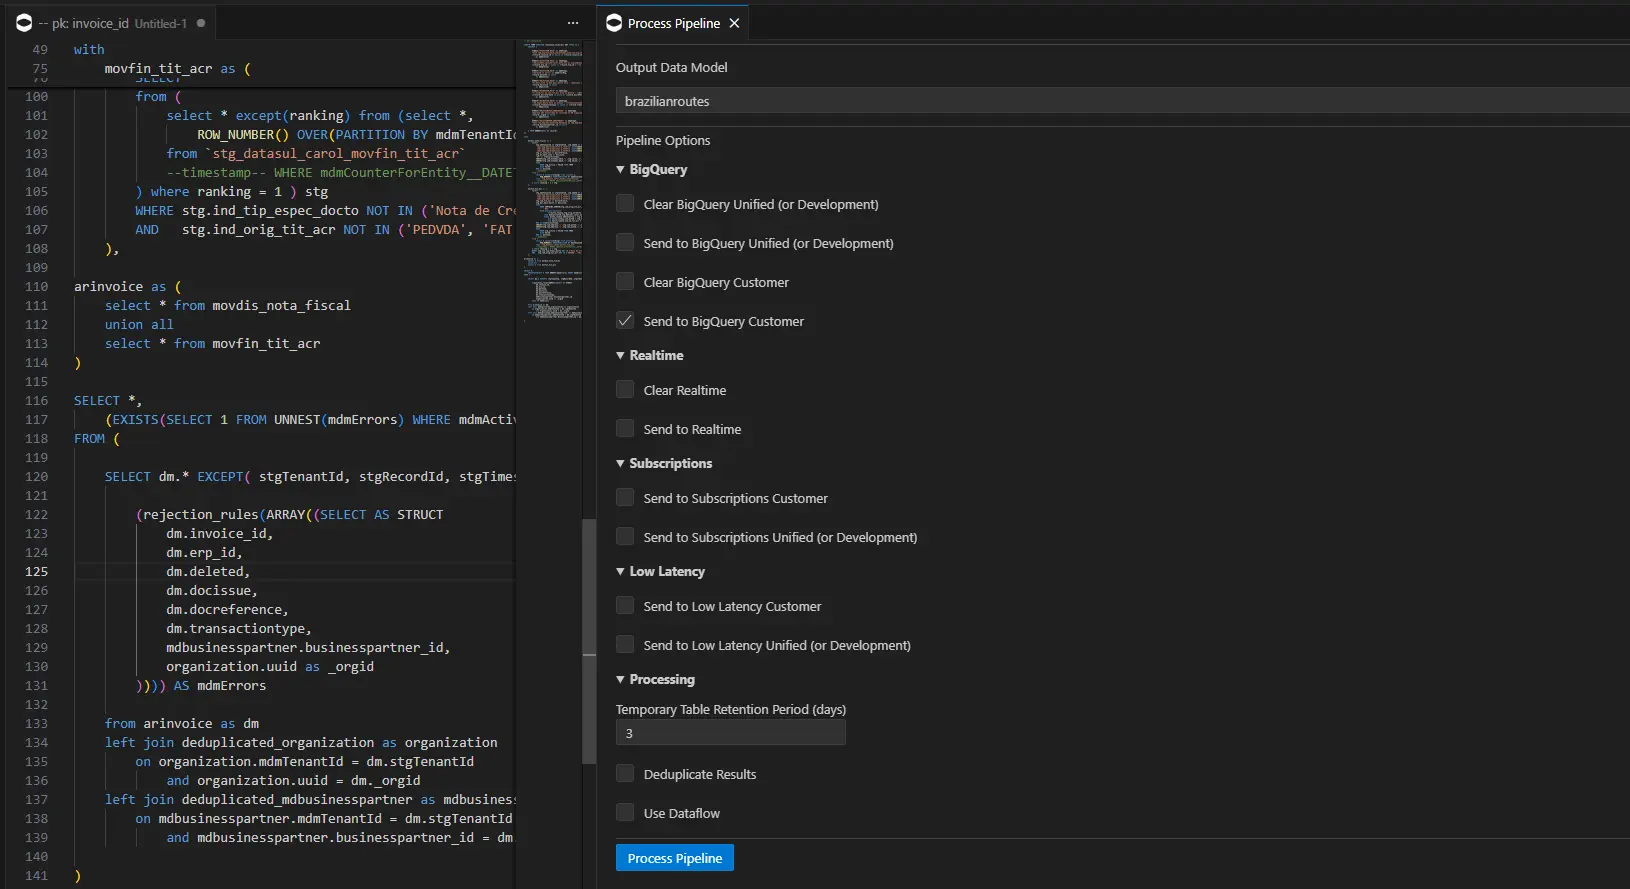
Os parâmetros disponíveis:
Arquivo CSQL: este é o arquivo correspondente pela pipeline.Output Data Model: datamodel que a Carol irá armazenar os dados.BigQuery - Clear BigQuery Unified (or Development): indica para a Carol para limpar o storage Bigquery antes de salvar os novos dados na tenant do tipo Unificada ou de Desenvolvimento.BigQuery - Send to BigQuery Unified (or Development): indica para a Carol salvar os dados processados no storage Big Query na tenant do tipo Unificada ou de Desenvolvimento.BigQuery - Clear BigQuery Customer: indica para a Carol para limpar o storage Bigquery antes de salvar os novos dados na tenant do tipo Customer (apenas quando executada no ambiente Customer).BigQuery - Send to BigQuery Customer: indica para a Carol salvar os dados processados no storage Big Query na tenant do tipo Customer (apenas quando executada no ambiente Customer).Realtime - Clear Realtime: indica para a Carol limpar a camada Realtime antes de inserir os novos dados.Realtime - Send to Realtime: indica para a Carol salvar os dados na camada Realtime (RT).Subscriptions - Send to Subscriptions Customer: indica para a Carol enviar os dados processados para as subscriptions do data model output cadastradas na tenant do tipo Customer. Caso o registro tenha o atributo mdmDeleted como falso, será enviado a mensagem de eliminação no Data Subscription.Subscriptions - Send to Subscriptions Unified (or Development): indica para a Carol enviar os dados processados para as subscriptions do data model output cadastradas na tenant do tipo Unificada ou Desenvolvimento.Low Latency - Send to Low Latency Customer: indica para a Carol enviar os dados para a camada baixa latência da plataforma IDEIA na tenant do tipo Customer (apenas quando executada no ambiente Customer).Low Latency - Send to Low Latency Unified (or Development): indica para a Carol enviar os dados para a camada baixa latência da plataforma IDEIA na tenant do tipo Unificada ou de Desenvolvimento.Processing - Temporary Table Retantion Period (days): Tempo em dias de retenção dos dados na tabela temporária de processamento no BigQuery (tabelas temporárias)Processing - Deduplicate Results: indica para a Carol realizar deduplicação de registros resultantes da pipeline de acordo com o Id do registro gerado no processamento.Processing - Use Dataflow: indica para a Carol utilizar o Dataflow para processar os dados. Este valor quando enviado false é gerenciado automaticamente pela Carol dependendo do tamanho dos dados processados na pipeline.
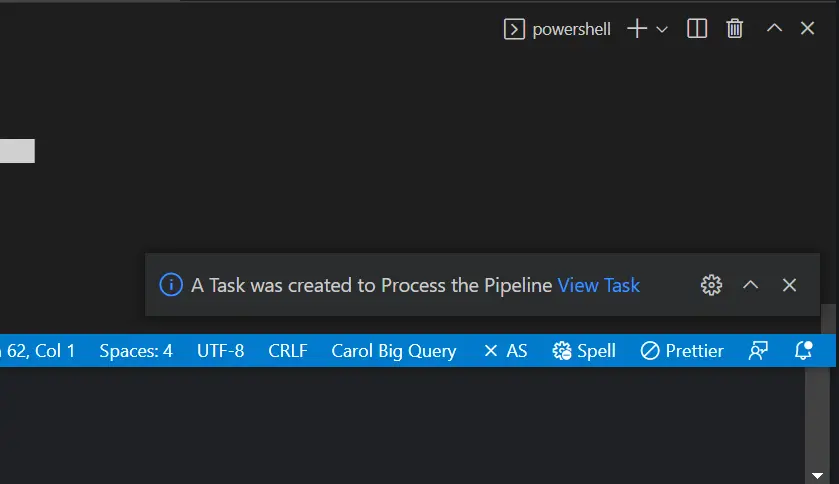
Quando o botão Process Pipeline é acionado, a mensagem de confirmação aparecerá juntamente com o link para acessar a task criada para processar os dados:
Carol: View Manifest
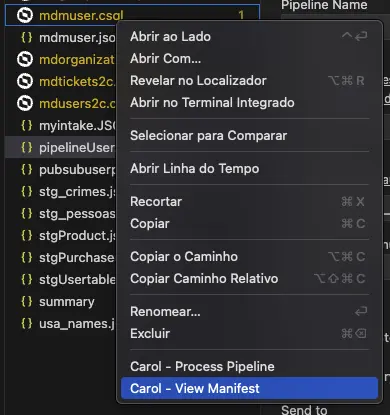
Este comando permite criar um manifesto a partir de uma pipeline existente. Para isto, o desenvolvedor precisa clicar no arquivo .csql da pipeline com o botão direito do mouse e selecionar a operação Carol - View Manifest.
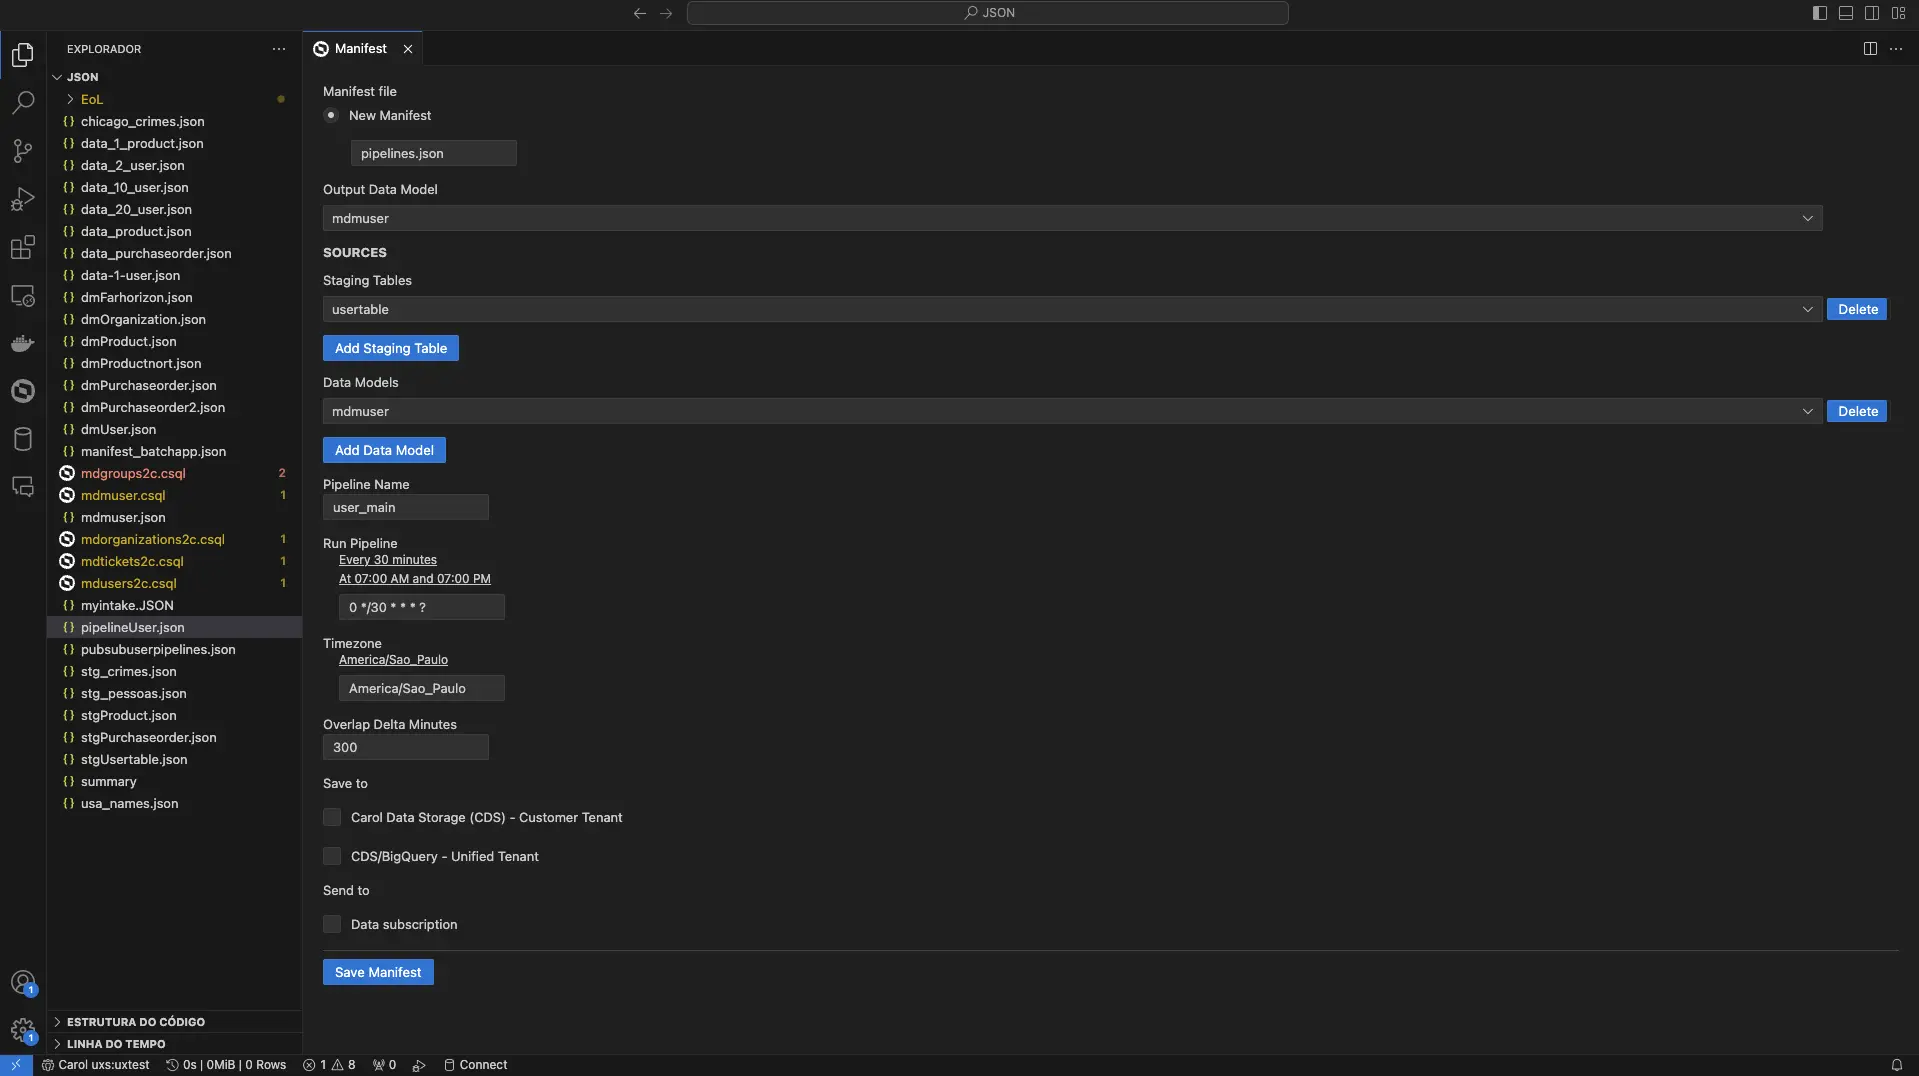
Os parâmetros disponíveis:
New Manifest: indica a criação de um novo manifesto e traz por convenção o nome padronizado ao arquivo como pipelines.json, porém editável pelo desenvolvedor.Output Data Model: indica o data model de destino do processamento dos dados.SOURCES: agrupador indicando as origens dos dados a serem processados.Staging Tables: indica quais tabelas com registros brutos serão utilizadas no processamento. As tabelas podem ser adicionadas ou removidas, por meio do botão disponível.Data Models: indica quais tabelas com registros já processados serão reutilizadas no processamento. As tabelas podem ser adicionadas ou removidas, por meio do botão disponível.Pipeline Name: indica o nome a ser atribuído a pipeline.Run Pipeline: indica os períodos de execução programada da pipeline por meio da expressão cron a ser configurada pelo desenvolvedor.Timezone: indica o fuso horário da região do calendário de execução. Por padrão o timezone definido é America/Sao_Paulo.Overlap Delta Minutes: indica a quantidade de minutos que será executado em sobreposição em relação à última execução desta pipeline. Caso seja a primeira execução, a pipeline será executada sem restrição de dados pela janela de recebimento dos dados (equivalente a um processamento inicial).Save to: agrupador indicando onde será salvo o resultado da pipeline.Carol Data Storage (CDS) - Customer Tenant: indica que o resultado da pipeline deve ser salvo no storage type CDS da tenant cliente.CDS / BigQuery - Unified Tenant: indica que o resultado da pipeline deve ser salvo em ambos os storage types (CDS e BigQuery) da tenant unificada (ambiente centralizador dos dados, responsável por processar os dados em escala).Send to: agrupador indicando onde será enviado o resultado da pipeline.Data Subscription: indica que ao término da execução da pipeline, os resultados devem ser enviados via data subscription (caso o data model tenha essa configuração). O envio do data subscription ocorre pelas tenants clientes. Registros incluídos e registros removidos são enviados via Data Subscription.
Quando o botão Save Manifest é acionado, será criada a partir dos parâmetros informados, a estrutura base do manifesto facilitando o processo posterior de configuração pelo desenvolvedor.
Carol - View Execution Graph
Este comando exibe um diagrama interativo com a cadeia de execução das pipelines de um manifesto, mostrando a ordem de execução definida em nextPipelines e quais pipelines são disparadas por expressão cron. Ao selecionar uma pipeline no diagrama, são exibidos seus detalhes, como origens de dados, data model de destino e possíveis alertas.
Além disso, exibe informações complementares de cada pipeline, como qual camada irá processar os dados, quais tabelas serão utilizadas como origem e destino, e possíveis alertas de configuração.
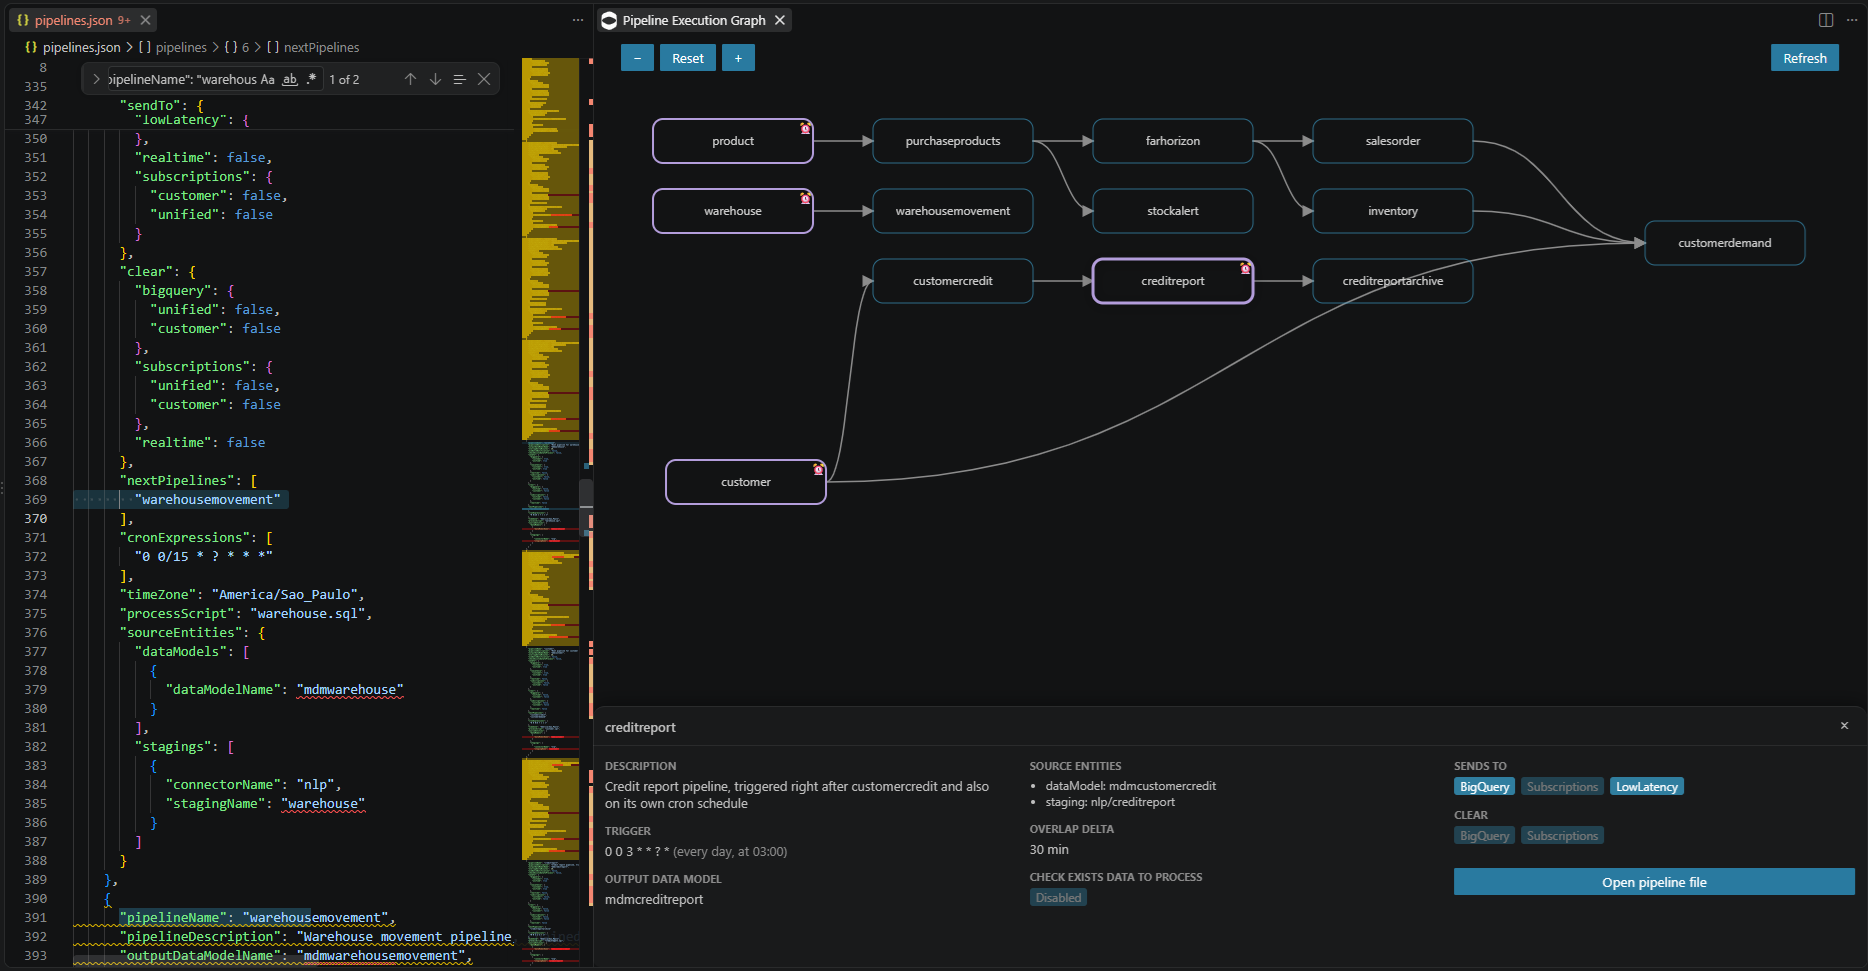
Para utilizá-lo, clique com o botão direito do mouse no arquivo do manifesto e selecione a operação Carol - View Execution Graph.
Este comando está disponível apenas para arquivos com o nome pipelines.json.
Carol - Upload Data
O comando upload-data permite a subida de arquivos no formato .json ou .csv para a Carol.
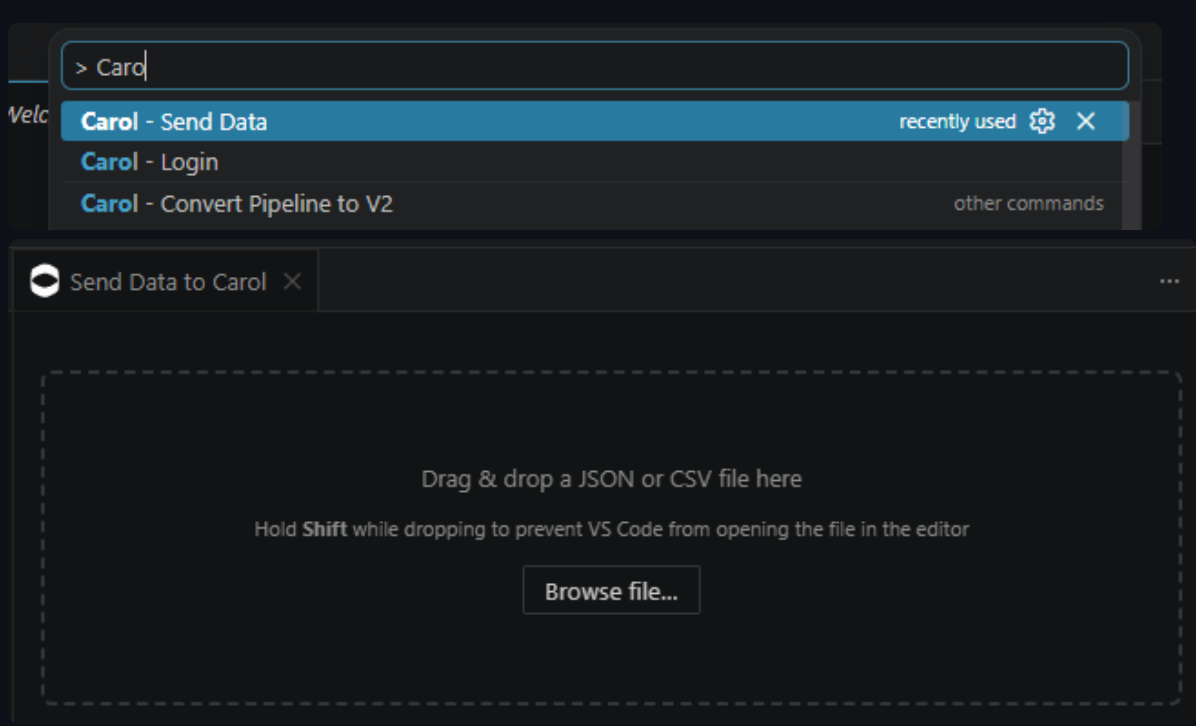
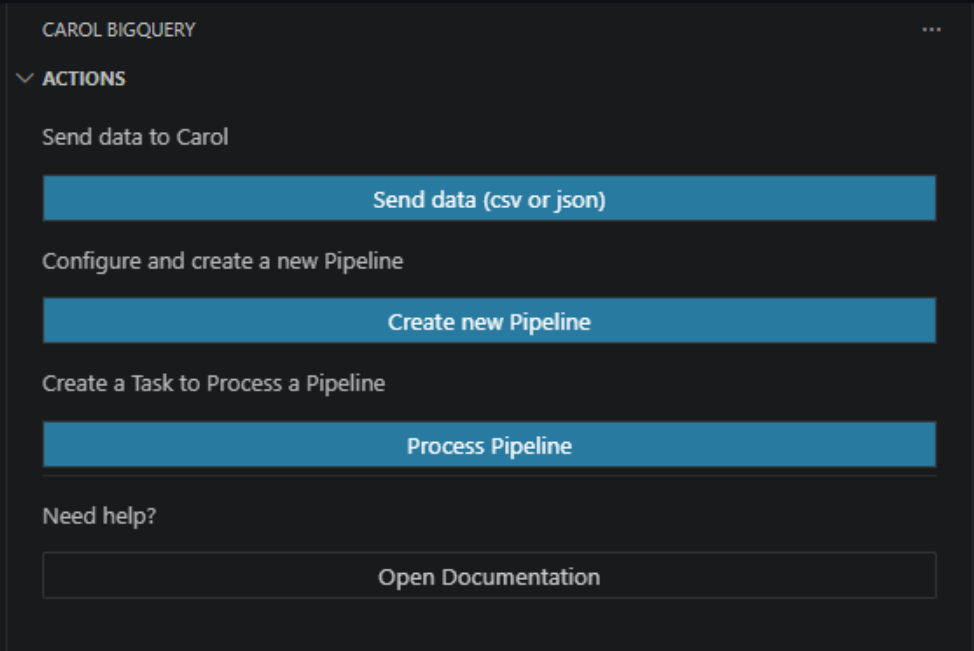
- Selecione o arquivo que você deseja subir. (o limite é parametrizavel, vide sessão Tamanho limite de arquivo)
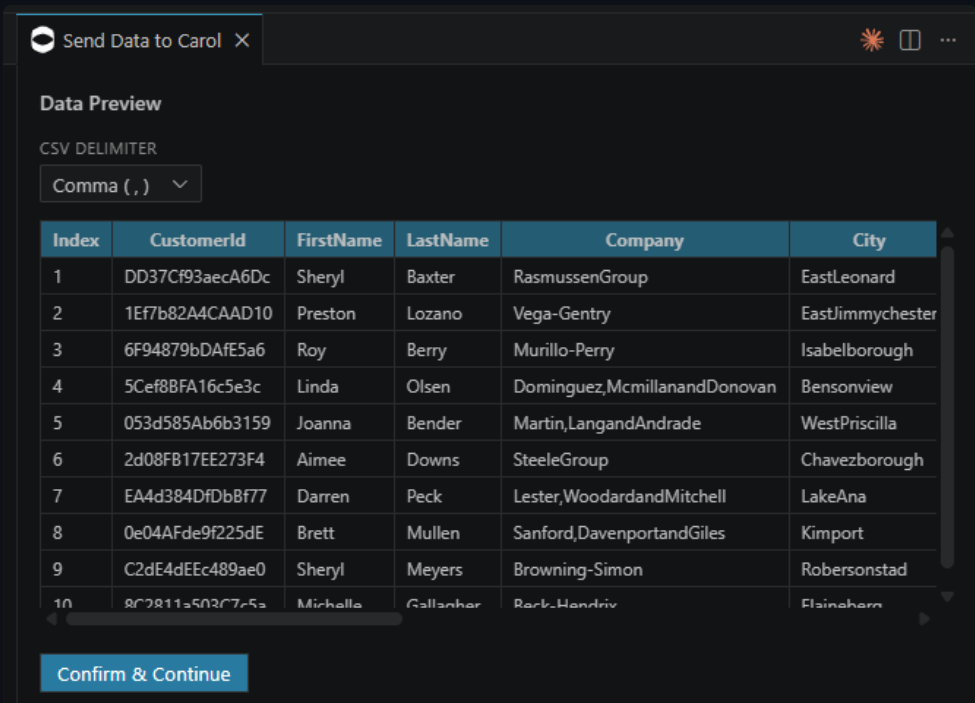
- Separe e confirme os delimitadores
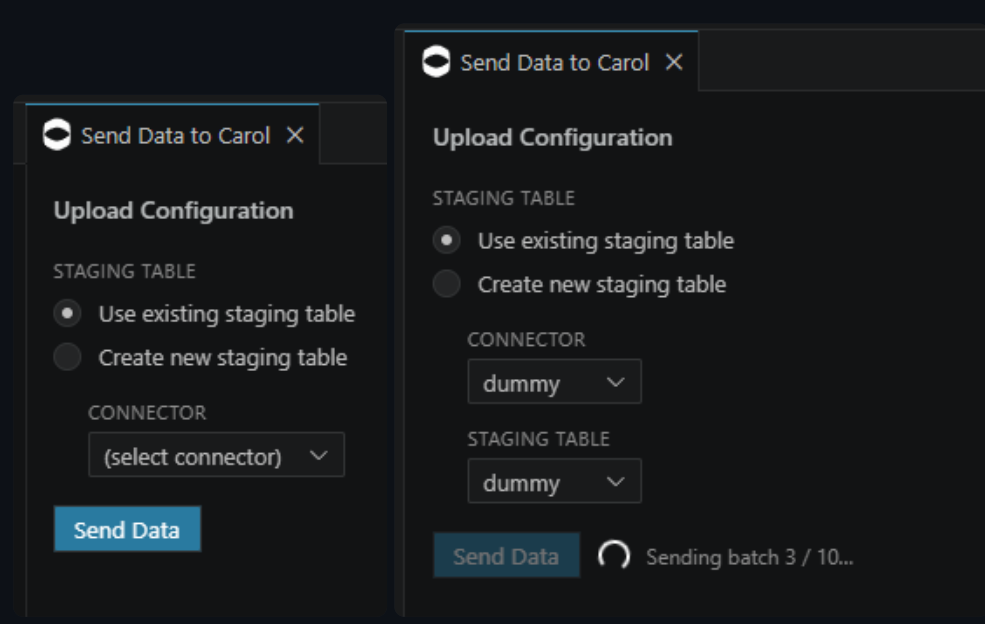
- Escolha se você quer subir dados para uma tabela já existente ou criar uma nova.
- Selecione o conector que receberá os dados dessa tabela.
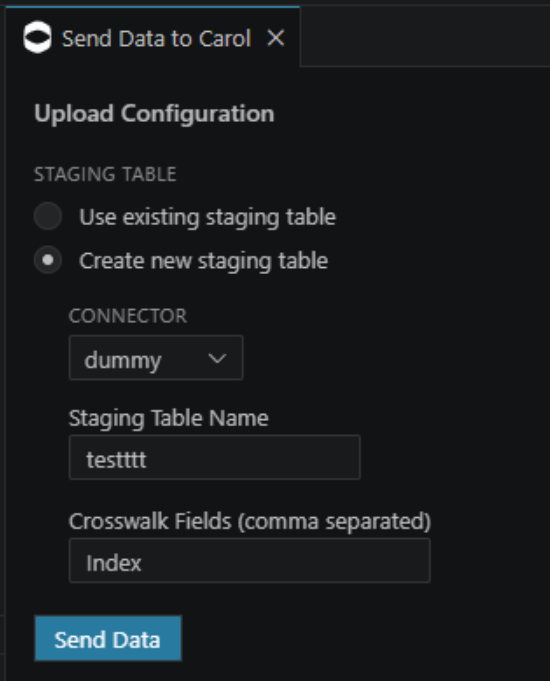
- Defina o nome da staging table que receberá esses dados.
- Em caso de ser uma tabela nova, coloque o crosswalk, ou seja, a chave primária da tabela (caso exista mais de um crosswalk, separá-los por vírgula)
- Ao clicar em send data, os dados serão enviados para Carol:
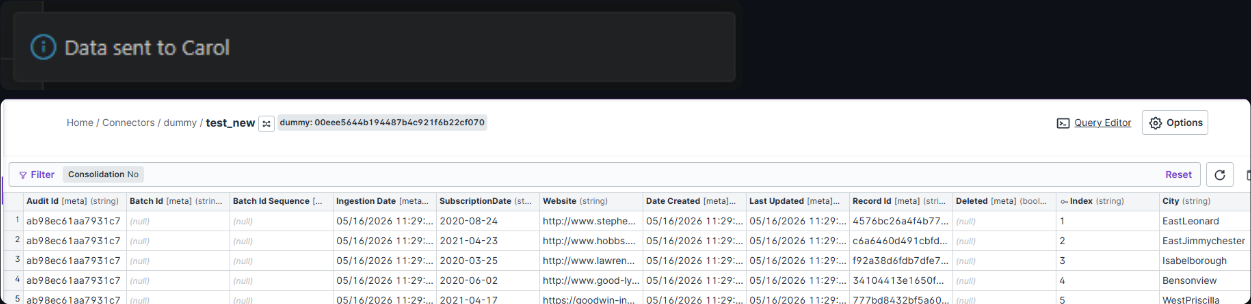
Tamanho limite de arquivo
O tamanho máximo de arquivo a ser enviado é parametrizavel. Por default, o máximo é 25MB. Para customizar, basta mudar o valor em Settings:
- Abra as Settings do VSCode
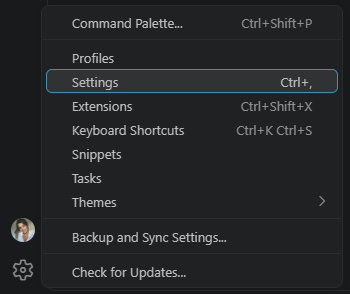
- Buscar por Labs-vscode:
Send Data To Carol Max File Size - Modificar o valor e clicar em "Backup and Sync Settings"
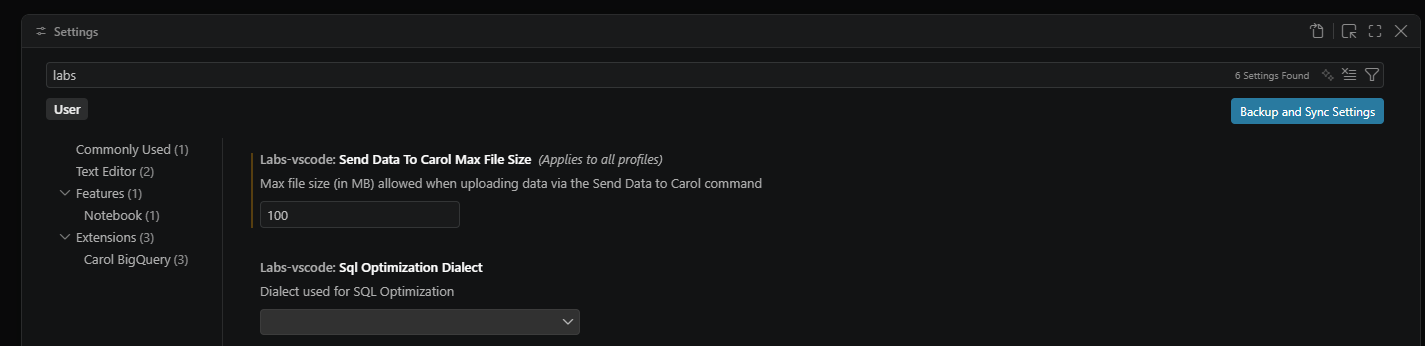
- Fechar e abrir o VsCode para atualizar a modificação.
Agente de Otimização de consultas SQL
No menu de processamento de pipelines e execução de queries, está disponível a funcionalidade SQL Optimization by Carol Agent, capaz de otimizar consultas SQL nos bancos de dados:
- BigQuery. (padrão)
- PostgreSQL.
- Microsoft SQL Server.
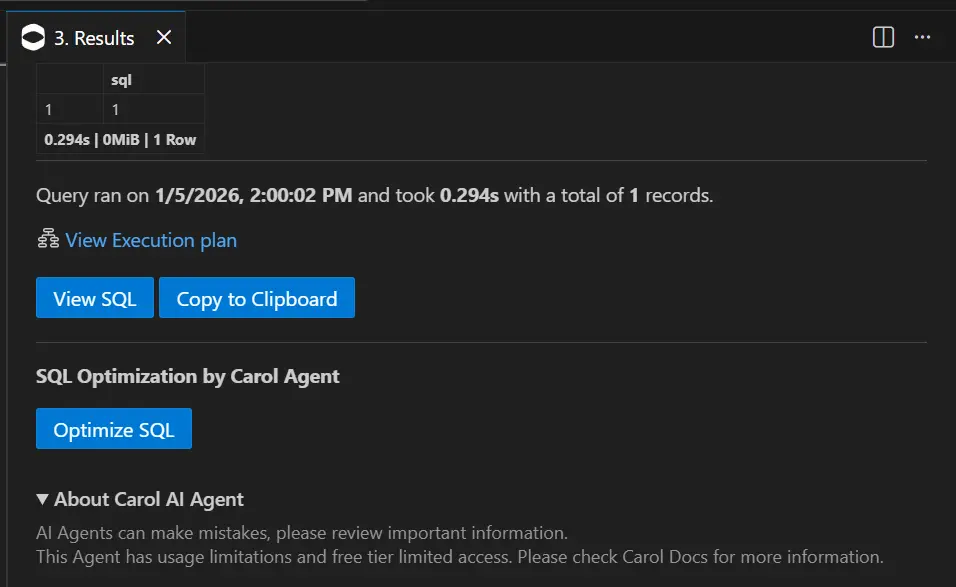
O Agente de otimização de consultas SQL pode sugerir otimizações nas consultas e exibe as diferenças da forma abaixo após ser iniciado.
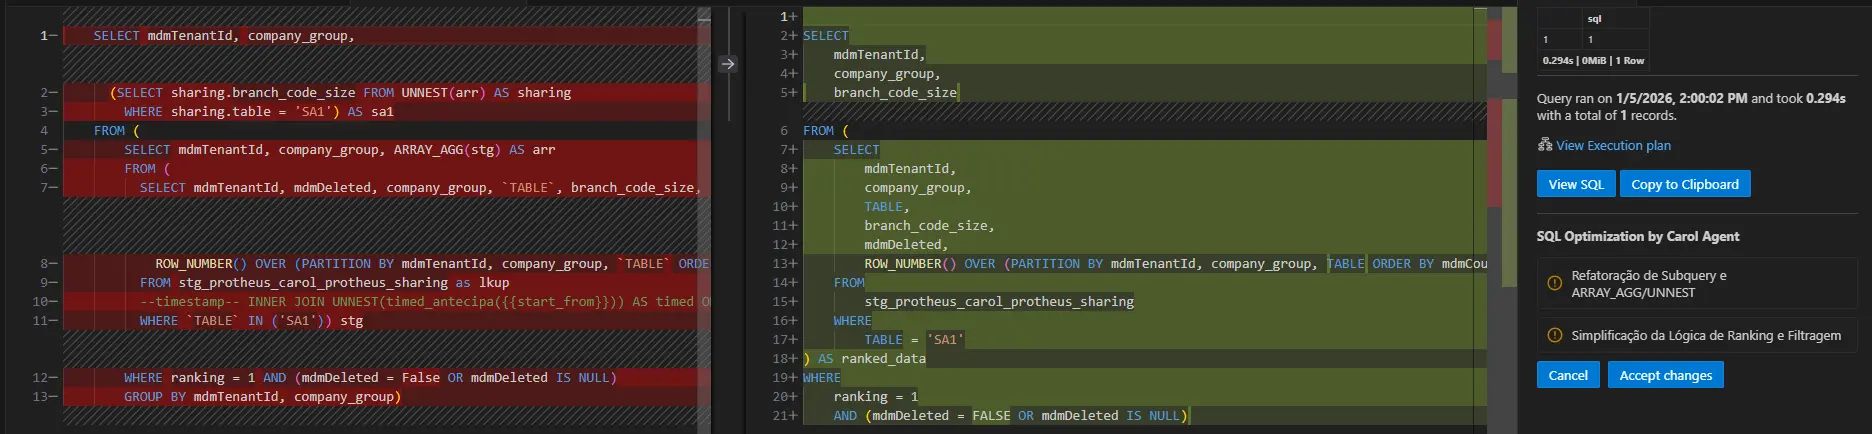
Limites de uso e configurações adicionais podem ser encontradas em sua documentação específica.
Desenvolvimento com Copilot
O fluxo recomendado para desenvolver pipelines SQL na Carol é o plugin TOTVS Carol com o GitHub Copilot. O plugin traz o Carol MCP Server, que dá ao Copilot acesso à tenant ativa: ele consulta staging tables e data models, lê esta documentação e valida a query com dry run antes de você processar a pipeline.
Com isso, o Copilot deixa de sugerir SQL genérico e passa a escrever, revisar e depurar pipelines com base nos campos reais da sua tenant e nas regras da Carol.
Pré-requisitos
- Visual Studio Code 1.109 ou superior.
- Plugin TOTVS Carol 2.0 ou superior, com login feito em uma tenant (veja Instalação).
O Carol MCP Server usa as credenciais da tenant ativa, exibida no rodapé do VS Code, e é reiniciado automaticamente quando você troca de tenant ou sai dela.
Ativar o Copilot
- Abra o Chat do VS Code pelo ícone do Copilot na barra de título ou pelo atalho
Ctrl + Alt + I(⌃ + ⌘ + Ino macOS). - No seletor de modo do Chat, escolha Agent. É nesse modo que o Copilot usa as ferramentas do Carol MCP Server.
Conferir o Carol MCP Server
O servidor é registrado pelo próprio plugin, sem configuração manual. Para conferir:
- Abra a paleta de comandos (
Ctrl + Shift + P) e execute MCP: List Servers. - Confirme que Carol MCP Server aparece e está em execução.
- No Chat, clique no ícone de ferramentas (Configure Tools) e confirme que as ferramentas da Carol estão marcadas.
Ferramentas disponíveis:
| Ferramenta | O que faz |
|---|---|
pipeline_creation_guidelines | Roteiro de criação de pipeline com boas práticas. |
list_documentation_links | Lista as páginas desta documentação. |
get_documentation_content | Lê o conteúdo de uma página desta documentação. |
get_current_organization | Mostra a organização ativa. |
get_current_tenant | Mostra a tenant ativa. |
list_staging_tables | Lista as staging tables dos conectores da tenant. |
get_staging_table_fields | Mostra os campos de uma staging table. |
list_data_models | Lista os data models da tenant. |
get_data_model_fields | Mostra os campos de um data model. |
dry_run_query | Valida uma query sem executar, retornando custo e erros. |
create_staging_table | Cria uma staging table na tenant. |
create_connector | Cria um conector na tenant. |
create_staging_table e create_connector alteram a tenant. Por padrão, o Copilot pede confirmação antes de executar uma ferramenta: leia os parâmetros antes de aprovar.
Construir a pipeline
Abra no VS Code a pasta do projeto, com os arquivos .csql e o pipelines.json. Peça ao Copilot o que você quer construir, citando a staging table de origem e o data model de destino. Exemplo:
Crie uma pipeline que leva a staging product do conector protheus_carol para o data model Product.
O Copilot segue o roteiro abaixo, e você pode pedir cada etapa separadamente:
- Lê a documentação de Pipelines e Manifesto para seguir as regras da Carol.
- Consulta a staging table de origem e os campos dela.
- Consulta o data model de destino e mapeia os campos.
- Escreve a pipeline em um arquivo
.csql. - Valida a query com dry run.
- Registra a pipeline no
pipelines.json, com o agendamento adequado.
Depois de revisar o resultado, processe a pipeline pelo comando Carol: Process Pipeline.
Revisar e depurar
O Copilot também ajuda em pipelines que já existem. Exemplos de pedidos:
Revise este .csql seguindo as guidelines de pipelines da Carol.O dry run retornou este erro: <erro>. O que está errado?Quais campos obrigatórios do data model Product esta pipeline não preenche?Explique o que esta pipeline faz, etapa por etapa.
Para otimizar custo e desempenho de uma query, use também o Agente de Otimização de consultas SQL.
Boas práticas
- Revise todo código gerado antes de processar. O Copilot acelera, mas a responsabilidade pela pipeline continua sendo sua.
- Rode o dry run antes de cada processamento.
- Confira se a pipeline segue as Guidelines para pipelines SQL, como o alias
stgna staging principal e o token de metadados--metadata-v2--. - Nunca cole tokens, senhas ou dados sensíveis no Chat.