Sua primeira pipeline
Versão para revisão. O exemplo está em preparação para publicação nos docs e samples.
Neste tutorial, você vai simular a integração de um sistema de vendas com a Carol. O sistema envia pedidos com código, quantidade e preço unitário. Depois, a quantidade de um pedido muda de 2 para 4 unidades, e os dados atualizados são enviados novamente.
Você fará o papel desse sistema, enviando os dados por um endpoint de API REST. Na Carol, criará uma pipeline SQL, o código que trata esses dados, para calcular o valor de cada pedido usando a versão mais atual de cada registro.
Ao final, você conferirá se a nova quantidade e o valor recalculado aparecem corretamente nos dados prontos para uso na sua aplicação.
Os dados são fictícios e serão armazenados em sua tenant dev.
Seu ambiente para o exemplo
| Recurso | O que usar neste exemplo |
|---|---|
| Organização | A organização da sua tenant dev. |
| tenant dev | Seu ambiente de teste. |
| Carol App | Um nome escolhido por você e disponível na plataforma. |
| connector | crm_demo |
| staging table (STG), tabela raw | pedidos |
| data model (DM), tabela de negócio | guiapedidos |
Crie o connector, a STG e o DM conforme a tabela para usar os arquivos do exemplo sem alterar as referências de origem e destino.
Sua jornada em 7 passos
- Prepare seu ambiente de teste
- Crie as tabelas
- Envie os dados
- Monte suas regras de negócio
- Execute e confira os resultados
- Agende e acompanhe as execuções
- Entenda a cobrança
Você pode realizar as configurações e operações na Carol pela interface (UI), usando as telas da plataforma, ou pelas APIs, a partir de código ou de outros sistemas.
Passo 1: Prepare seu ambiente de teste
Uma tenant é o ambiente do projeto. Use uma tenant dev (tipo DEVELOPMENT) com acesso de Tenant Admin. Se já tem esse ambiente pronto, pule para o passo 2. Caso precise solicitá-lo:
- Abra o formulário da Plataforma Carol.
- Selecione Desenvolvimento e Quero criar / provisionar um ambiente / tenant na Carol.
- Se o projeto recebe dados do Smartlink, solicite a organização
totvstechfindev. Caso contrário, solicitetotvs.
Depois do envio do formulário, acompanhe o chamado criado. A equipe interna criará sua tenant dev e enviará as informações de acesso pelo chamado.
Não se preocupe com os custos: são poucas requests (chamadas à API), com poucos dados. O consumo inicial tende a ser baixo, próximo de zero.
Passo 2: Crie as tabelas
Um connector representa uma origem de dados na Carol, como um ERP ou um sistema de
vendas. Ele reúne as tabelas que recebem dados dessa origem. Aqui, vamos criar o
connector crm_demo, simulando um sistema de CRM que fornece os pedidos do exemplo.
Uma staging table (STG) é uma tabela raw, ou seja, uma tabela de dados brutos, armazenada no BigQuery. Ela guarda os registros recebidos antes de a pipeline converter os tipos dos campos, fazer cálculos e aplicar as regras de negócio.
Crie a tabela que recebe os dados
Em connectors, crie crm_demo e, dentro dele, a STG pedidos.
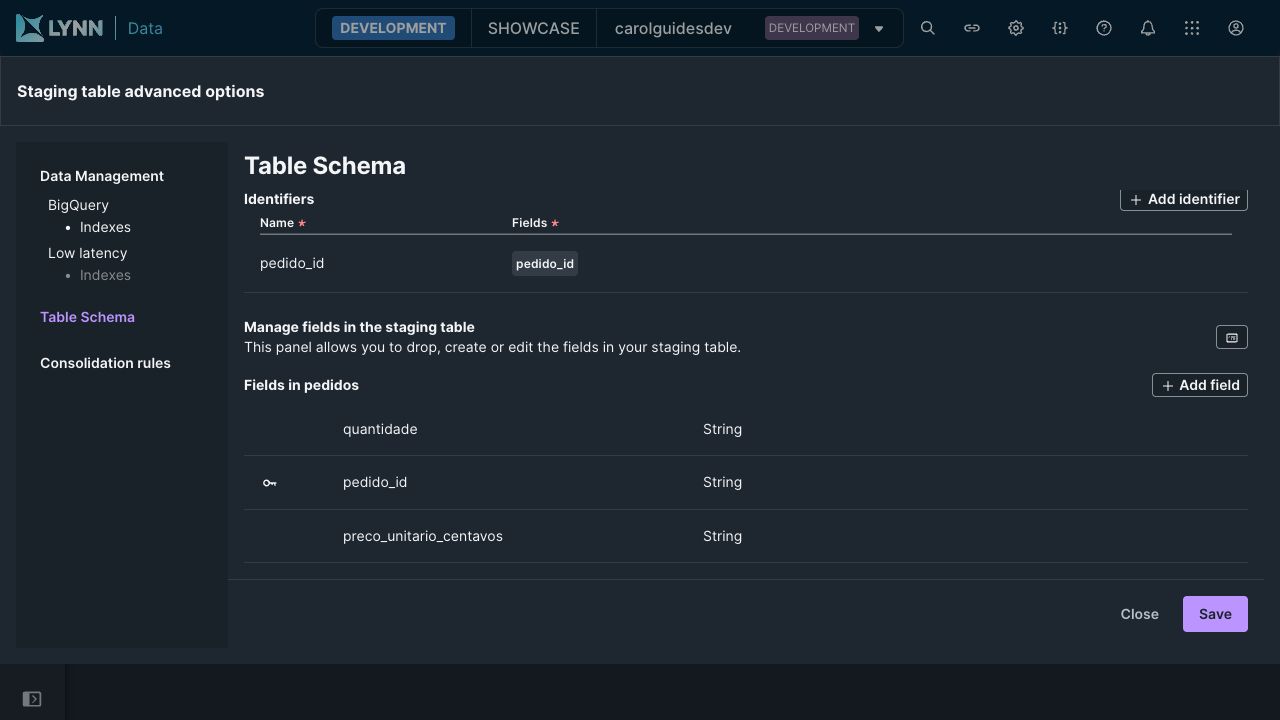
Em Options → Table Schema, configure os três campos como STRING (texto):
| Campo | Tipo | Chave primária? |
|---|---|---|
pedido_id | STRING | Sim |
quantidade | STRING | Não |
preco_unitario_centavos | STRING | Não |
A chave primária é obrigatória. Também conhecida como crosswalk, ela pode ser
formada por um único campo ou por um conjunto de campos. Neste exemplo, usamos apenas pedido_id. A Carol usa essa chave para gerar o mdmId, que identifica as versões do mesmo registro.
Flexible permite criar novas colunas na STG quando chegam campos que ainda não
estão cadastrados. Se um pedido passar a incluir canal, por exemplo, a Carol poderá
adicionar essa coluna automaticamente.
Em Options → Data Management, mantenha Flexible desativado neste exercício, pois os três campos já estão definidos.
Crie a tabela com os dados tratados
Em data models → Add a data model, selecione um projeto do ambiente e preencha:
- name:
guiapedidos, o identificador único do DM. - label:
Pedidos do tutorial, o identificador descritivo exibido na interface da Carol.
Esse DM é a tabela de negócio que representa os pedidos com dados tratados.
| Campo | Tipo |
|---|---|
pedido_id | STRING |
quantidade | LONG |
preco_unitario_centavos | LONG |
valor_total_centavos | LONG |
Os campos dos DMs pertencem à tenant e podem ser reutilizados em vários DMs.
Se quantidade foi criado como LONG, esse tipo deve ser mantido em todos os DMs
que usarem esse campo.
Nome e tipo ficam fixos após a criação. Para mudá-los, é preciso excluir e recriar o campo. A exclusão só é permitida quando nenhum DM estiver usando o campo.
Inclua no DM os quatro campos da tabela, com os tipos indicados. Se o campo já estiver cadastrado na tenant, selecione-o; se ainda não existir, crie-o.
Preencha a descrição de cada campo e publique o DM para que a pipeline possa usá-lo.
Consulte os detalhes sobre campos, chaves e tipos de dados.
Passo 3: Envie os dados
O Swagger é a interface onde você consulta os endpoints disponíveis das APIs da Carol e pode executá-los. Neste exemplo, você enviará os dados manualmente por um endpoint; em uma integração, esse envio poderia ser feito por um app externo ou pelo Smartlink.
Faça o envio
- No cabeçalho da Carol, abra ⋮ → Carol Swagger. Confira organização e tenant dev e selecione a versão V6.
- Abra POST
/api/v6/staging/intake/{table}e ative Try it out, se aparecer. - Preencha os parâmetros abaixo, cole o conteúdo completo de pedidos.json no body e clique em Execute.
| Parâmetro | Valor | Onde obter |
|---|---|---|
connectorId | ID de crm_demo | connectors → crm_demo → connector details, ou botão de copiar connector ID na lista. |
table | pedidos | Nome em connectors → crm_demo, na lista de STGs. |
returnData | false | Preencha neste envio. |
batchId e batchIdSequence | Vazios | Não usados neste envio pequeno. |
Os valores do arquivo estão entre aspas porque a entrada é STRING.
Confira a chegada
Volte a connectors → crm_demo → pedidos, remova a tag Showing Table Preview pelo X e atualize. O preview é uma amostra em cache; sem a tag, a Carol consulta o BigQuery.
Confira: três pedidos na STG. A resposta da API confirma aceitação, mas a gravação é assíncrona. Com o schema pronto, a referência operacional é de cerca de 95% dos envios chegando em menos de um minuto. Aguarde e atualize antes de reenviar.
Saiba mais: caminho dos registros até o BigQuery
Ao enviar os pedidos, a Carol recebe e valida a requisição. Se o envio for aceito, a API retorna sucesso. Nesse momento, os registros ainda podem estar a caminho do BigQuery.
O que acontece depois do sucesso:
- Os registros passam pela fila interna NATS e pelo Pub/Sub.
- Os serviços de ingestão gravam os registros na tabela física da STG no BigQuery.
- Após a gravação, os dados ficam disponíveis para consulta.
O volume enviado, as filas e o estado dos serviços podem influenciar o tempo de chegada.
Confira na STG: o retorno de sucesso confirma a aceitação do envio, mas não que a gravação já terminou. Aguarde e atualize a consulta antes de reenviar os dados.
Entenda as versões dos dados
A cada request, a Carol grava os registros por inserções. Se um pedido muda na origem e a integração envia a alteração, chega uma nova versão; a anterior continua armazenada.
mdmId: identidade do registro
Na STG, a Carol gera esse hash a partir da chave primária. P001 mantém o mesmo
mdmId quando sua quantidade muda. No DM, você define a identidade pelo código da
pipeline, como veremos no passo 4.
Saiba mais: como escolher a identidade
Neste exemplo, a chave é pedido_id: P001 e P002 são pedidos diferentes e recebem
hashes diferentes. Quantidade e preço podem mudar e não fazem parte da chave.
Uma chave estável permite reconhecer as novas versões do mesmo registro.
mdmCounterForEntity: horário de recebimento
Na STG, é um LONG com a data e hora de recebimento na Carol, em microssegundos.
Um envio posterior recebe um valor maior. Registros da mesma request têm o mesmo
contador; o mdmId permite distinguir os registros.
Saiba mais: horários e contadores na STG e no DM
| Onde | Campo | Significado |
|---|---|---|
| STG | mdmCounterForEntity | Momento de recebimento daquela versão. |
| DM | mdmStagingCounter | Recebimento da origem que gerou o resultado. |
| DM | mdmCounterForEntity | Momento de processamento do resultado pela pipeline. |
Esses horários ajudam a identificar quando os dados chegaram à Carol e quando foram processados.
_ingestionDatetime: horário de gravação
É a data e hora da gravação, após os dados passarem pela fila de ingestão. A diferença para o horário de recebimento mostra quanto tempo levou até essa gravação.
Saiba mais: tempo de ingestão e filtro de partição
A diferença entre o recebimento na Carol e a gravação no BigQuery mostra quanto tempo os dados levaram para chegar à tabela.
O _ingestionDatetime é um campo importante: ele é a partição padrão das tabelas no BigQuery.
Exemplo: atualização e exclusão de um pedido
P001 e P002 chegam juntos. Depois, P001 muda de quantidade e, por fim, a origem comunica
sua exclusão com mdmDeleted = true.
pedido_id (chave primária) | quantidade | mdmId (hash) | mdmCounterForEntity (LONG) | mdmDeleted |
|---|---|---|---|---|
P001 | 2 | 76e0385b56514f0e65fb36def856bc6c | 1793664162833000 | false |
P002 | 3 | fcda4efc5db809776d16a2bbfa9f7200 | 1793664162833000 | false |
P001 | 4 | 76e0385b56514f0e65fb36def856bc6c | 1793664163138000 | false |
P001 | 4 | 76e0385b56514f0e65fb36def856bc6c | 1793664163436000 | true |
- Primeiro envio: a Carol recebe P001 com quantidade 2 e P002 com quantidade 3. Como são pedidos diferentes, cada um recebe um
mdmIddiferente. - Atualização de P001: a quantidade muda de 2 para 4, e o pedido é enviado novamente. A Carol grava uma nova versão com o mesmo
mdmId, pois continua sendo o mesmo pedido. O contador aumenta para indicar que essa versão chegou depois da anterior. - Exclusão de P001: a integração envia o pedido com
mdmDeleted = true. A Carol grava uma nova versão indicando a exclusão; as versões anteriores continuam na STG. P002 não recebeu alterações e permanece ativo, com quantidade 3.
Consolidação lógica: consulta da versão atual
É importante usar a consolidação lógica para evitar que versões antigas do mesmo registro sejam contadas junto com a versão atual, duplicando quantidades ou valores nos resultados.
- Você monta a consulta para escolher a versão mais atual de cada
mdmId. As versões antigas continuam armazenadas. - Primeiro escolha a última versão; depois verifique
mdmDeleted. No exemplo, P001 sai dos ativos e P002 continua aparecendo. - As views
deduplicated_ajudam a consultar a versão atual. Veja o tratamento no SQL no passo 4.
Consolidação física: limpeza das versões antigas
- A Carol remove versões antigas das tabelas físicas para reduzir o acúmulo e o volume armazenado. Isso vale para STGs e DMs.
- Com a consolidação habilitada, a plataforma executa a limpeza na rotina do fim de semana.
- Novos envios voltam a criar versões. Por isso, as consultas continuam precisando escolher a mais atual.
Veja mais detalhes sobre consolidação lógica e física.
Passo 4: Monte suas regras de negócio
Conheça os arquivos
O SQL contém a lógica de tratamento dos dados. Neste exemplo, ele calcula o valor de cada pedido.
O manifest funciona como uma definição da infraestrutura de execução da pipeline na Carol: informa a origem dos dados, o destino, qual código executar e a agenda.
| Arquivo | Função |
|---|---|
| pedidos.csql | SQL que escolhe a versão atual e calcula o valor do pedido. |
| pipelines.json | Manifest com SQL, origem, destino e agenda. Começa manual. |
| pipelines-scheduled.json | Variante com agendamento para dias úteis às 08h. |
O SQL converte o texto raw em inteiro antes de calcular:
cast(stg.quantidade as int64) * cast(stg.preco_unitario_centavos as int64)
  as valor_total_centavos
Importante: SQL completo e metadados
Metadados são informações que acompanham os dados de negócio, como a identidade do registro, sua origem e os horários de recebimento e processamento. Eles permitem reconhecer o mesmo pedido entre diferentes envios e acompanhar suas versões.
A tag --metadata-v2-- instrui a Carol a acrescentar ao SQL os metadados necessários para o DM. Neste exemplo, ela aproveita a identidade do registro na STG. Isso é importante para que uma atualização de P001 continue vinculada ao mesmo pedido no destino.
Em pedidos.csql, o CAST converte os campos raw de STRING para INT64,
o inteiro do BigQuery correspondente ao LONG do DM. Depois calcula o valor do pedido.
select
  stg.pedido_id,
  cast(stg.quantidade as int64) as quantidade,
  cast(stg.preco_unitario_centavos as int64) as preco_unitario_centavos,
  cast(stg.quantidade as int64) * cast(stg.preco_unitario_centavos as int64)
    as valor_total_centavos,
  coalesce(stg.mdmDeleted, false) as mdmDeleted
  --metadata-v2--
from `stg_crm_demo_pedidos` as stg
qualify row_number() over (
  partition by stg.mdmId
  order by
    stg.mdmCounterForEntity desc,
    stg.mdmLastUpdated desc,
    stg._ingestionDatetime desc
) = 1
Se um valor não puder ser convertido, a consulta falha e a origem precisa ser conferida. O texto original fica preservado na camada raw.
| Tag | Uso |
|---|---|
--metadata-v2-- | Aproveita a identidade da origem de alias stg, como neste exemplo. |
--metadataNoId-v2-- | Você fornece a identidade em __mdmId; a tag completa os demais metadados. |
Na segunda opção, o mesmo registro deve gerar a mesma identidade nas próximas execuções.
Não use quantidade, preço, data da execução ou valores aleatórios como identificador.
A tag continua precisando dos campos de origem do alias stg.
Veja a referência das tags.
Importante: Escolha da versão atual e tratamento de exclusões
A consulta de check-staging.sql seleciona a versão mais recente de cada pedido e mostra apenas os que continuam ativos:
select
  pedido_id,
  quantidade,
  preco_unitario_centavos,
  mdmId,
  mdmCounterForEntity,
  mdmDeleted
from `stg_crm_demo_pedidos`
qualify row_number() over (
  partition by mdmId
  order by
    mdmCounterForEntity desc,
    mdmLastUpdated desc,
    _ingestionDatetime desc
) = 1
  and coalesce(mdmDeleted, false) = false
order by pedido_id
Como a versão atual é escolhida
A consulta reúne as versões do mesmo pedido e as ordena da mais recente para a mais antiga. Depois, mantém apenas a primeira. Se dois envios tiverem o mesmo contador, os horários de atualização e gravação ajudam a definir a ordem. Essa leitura preserva as versões armazenadas na STG.
Como tratar uma exclusão
A consulta deve encontrar a última versão de P001 antes de verificar se ele foi excluído. Se essa versão tiver mdmDeleted = true, o pedido fica fora da lista de ativos.
Para informar uma exclusão, a integração precisa enviar o registro com essa marcação. Deixar de incluir P001 no próximo arquivo não informa à Carol que ele foi excluído. Quando mdmDeleted está como false ou vazio, o envio não indica exclusão.
A pipeline também precisa preservar essa marcação no resultado, como faz pedidos.csql. Dessa forma, o DM recebe a indicação de exclusão de P001, e as consultas ao destino podem tratá-lo corretamente.
Veja também as regras de rejeição e as orientações de performance para tabelas maiores.
Importante: Configurações do manifest
O manifest define a estrutura de execução da pipeline: qual SQL executar, de onde ler os dados, onde gravar o resultado e quando executar.
Identificação e execução
| Configuração | Para que serve | Neste exemplo |
|---|---|---|
pipelineName | Identifica a pipeline na Carol. | guia_pedidos |
processScript | Indica o arquivo com a lógica SQL. | pedidos.csql |
sourceEntities | Informa as tabelas de origem. | STG pedidos, do connector crm_demo |
outputDataModelName | Indica o DM que recebe o resultado. | guiapedidos |
cronExpressions | Define os horários de execução automática. | Lista vazia: execução manual |
timeZone | Define o fuso horário da agenda. | America/Sao_Paulo |
Ambiente de destino
As opções de envio distinguem dois destinos:
- unified: define o envio para a tenant unificada do app. Na tenant dev, essas mesmas opções controlam a gravação no próprio ambiente de desenvolvimento. Por exemplo,
sendTo.bigquery.unified: truehabilita a gravação no BigQuery da própria tenant dev. - customer: as tenants clientes em que o app está instalado. O envio para elas depende das configurações de distribuição da pipeline.
Camada de armazenamento
BigQuery é indicado para análises de grandes volumes, cruzamento de tabelas e cálculo de indicadores para relatórios e dashboards. O envio é configurado em sendTo.bigquery.
Baixa Latência é indicada para aplicações e agentes que precisam de consultas rápidas e filtradas, como buscar um pedido específico. O envio é configurado em sendTo.lowLatency.
A Baixa Latência usa o AlloyDB, um banco compatível com PostgreSQL e otimizado pelo Google. Consultas que percorrem muitos dados podem exigir mais recursos e demorar. Para análises amplas, prefira o BigQuery e disponibilize em Baixa Latência os dados necessários ao consumo rápido.
Para usar essa camada, habilite a Baixa Latência na tenant e no Data Model de destino, além de configurar o envio no manifest. Veja como habilitar o recurso.
Mesmo com Baixa Latência habilitada, os dados continuam persistidos no BigQuery como respaldo.
Configurações usadas neste exemplo
Neste tutorial, o resultado é gravado apenas no BigQuery da tenant dev. Nas opções abaixo, true habilita e false desativa o comportamento.
| Opção | Comportamento |
|---|---|
sendTo.bigquery.unified: true | Grava o resultado no BigQuery da tenant dev. |
sendTo.bigquery.customer: false | Não envia o resultado ao BigQuery das tenants clientes. |
clear: false em todos os destinos | Não limpa o DM antes de executar a pipeline. |
fanOut: false | Não distribui o resultado para as tenants clientes. |
sendTo.subscriptions: false | Não envia o resultado por Data Subscription. |
Conecte seu código à Carol
O Carol App é uma aplicação criada dentro da Carol que reúne o código e as configurações de uma solução. Ele pode ser usado para processar dados, executar rotinas ou disponibilizar APIs e páginas web.
Neste exemplo, você usará o Carol App para conectar o repositório Git à sua tenant dev e carregar a pipeline que trata os pedidos. Você escolhe o manifest e a versão do código que a Carol deverá usar.
-
Em Carol Apps → Developed Apps, crie um app com um nome próprio e disponível na plataforma. Esse nome não precisa ser informado no manifest
-
Abra App Config → Git connection, escolha Azure, BitBucket, GitHub ou Custom e clique em Next
-
Para GitHub e Azure, em Repository Visibility, selecione:
- Public: repositório público, sem necessidade de PAT
- Private: repositório privado. Gere um PAT (token de acesso pessoal) seguindo o guia do GitHub ou da Azure DevOps. Preencha a autenticação na Carol e clique em Connect
-
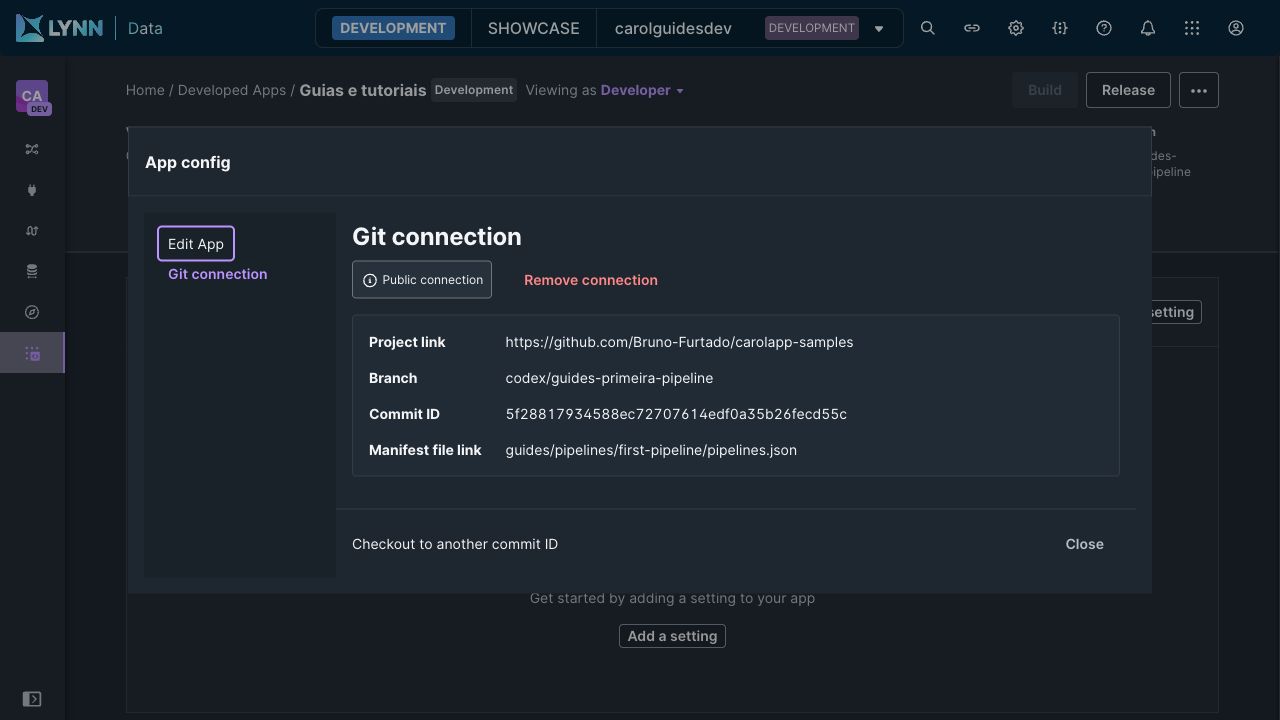
Em Project link, informe
https://github.com/Bruno-Furtado/carolapp-samples. Em Branch, selecionecodex/guides-primeira-pipelinee clique em NextO repositório guarda o código e seu histórico de versões. Use a URL principal, sem pastas ou arquivos
Durante esta revisão, use GitHub → Public, sem PAT. Os arquivos estão neste fork público. Após a aprovação e o merge da PR do exemplo, atualizaremos a referência para o repositório oficial
Sem repositório? Solicite a criação na Azure DevOps ao time de TI da TOTVS pelo Zendesk. Ao receber o acesso, adicione os arquivos do exemplo
-
Selecione o commit e informe o manifest em Relative path ou Manifest file link, quando o caminho for preenchido manualmente. Esse campo indica onde o arquivo está dentro do repositório. O caminho começa na primeira pasta, sem
/no início:guides/pipelines/first-pipeline/pipelines.jsonDepois, clique em Save
-
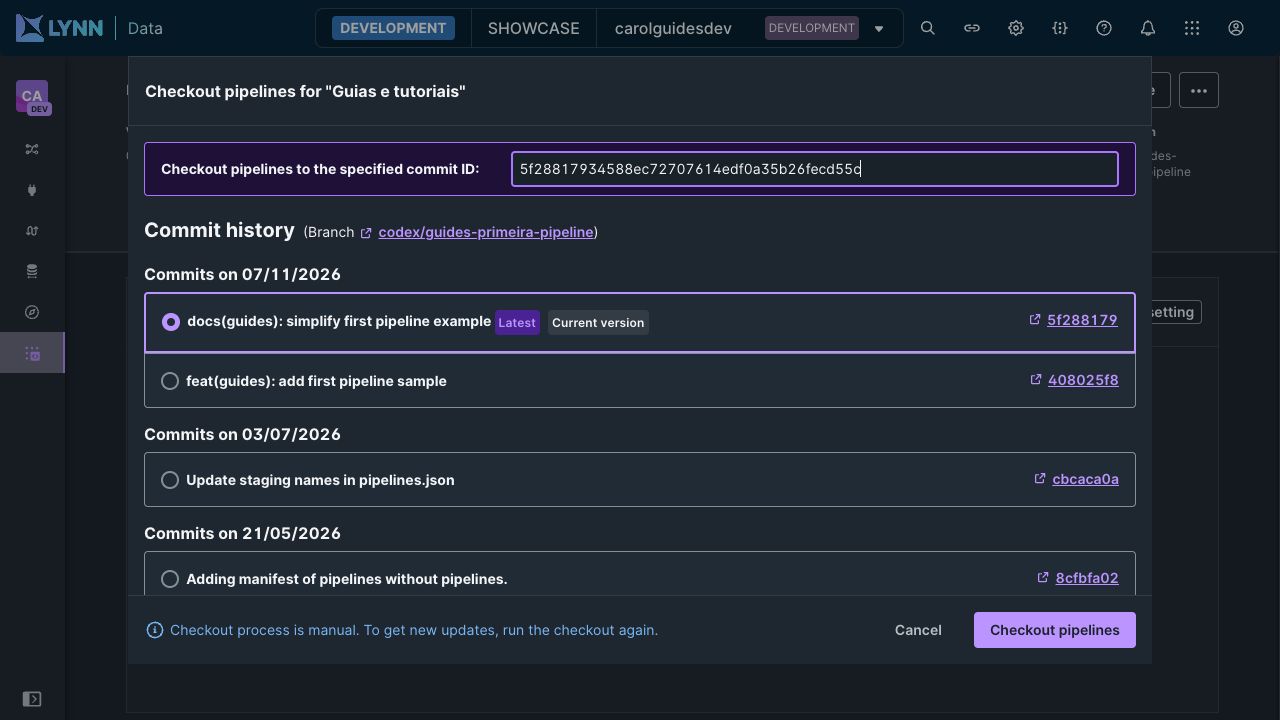
Na tela de resumo, clique em Checkout to another commit ID. Confira o commit e o manifest, confirme em Checkout pipelines e aguarde a conclusão
Azure DevOps da TOTVS: o grupo, chamado de organização na Azure, é
totvstfs.
Importante: Férias e atualização da pipeline
Quando a pessoa que gerou o PAT entra em férias
O PAT está ligado à conta que o criou. Se a TI suspender essa conta durante as férias ou um afastamento, o token perde acesso aos recursos da organização. A Carol pode deixar de acessar o repositório e de carregar novas versões da pipeline. O mesmo pode ocorrer se o PAT expirar ou for revogado.
Quando você envia um novo commit
Salvar e enviar uma alteração ao Git não atualiza automaticamente a pipeline na Carol. O checkout é a ação que busca a versão escolhida e carrega o código e o manifest na plataforma. Até fazer isso, a Carol mantém a versão carregada anteriormente.
Depois de enviar o commit para a branch configurada:
- Abra App Config → Git connection → Checkout to another commit ID
- Selecione o novo commit e confira o caminho do manifest
- Clique em Checkout pipelines e aguarde a conclusão antes de executar a versão atualizada
Saiba mais: Lentidão na busca pelo nome do Carol App
Ao criar um Carol App, a Carol consulta se o nome escolhido está disponível. Essa busca está apresentando lentidão, e a resposta pode demorar depois que você digita o nome. Aguarde o resultado antes de tentar outro nome ou avançar.
O time já está atuando na correção. Se você já confirmou a criação, confira a lista de apps e Activity Management antes de repetir a operação. Se a busca responder normalmente, siga o roteiro.
Passo 5: Execute e confira os resultados
Abra Pipelines e localize guia_pedidos, a pipeline carregada no passo anterior. Ela grava os pedidos tratados no DM guiapedidos. Você vai iniciar essa primeira execução manualmente; o agendamento será explicado no passo 6.
-
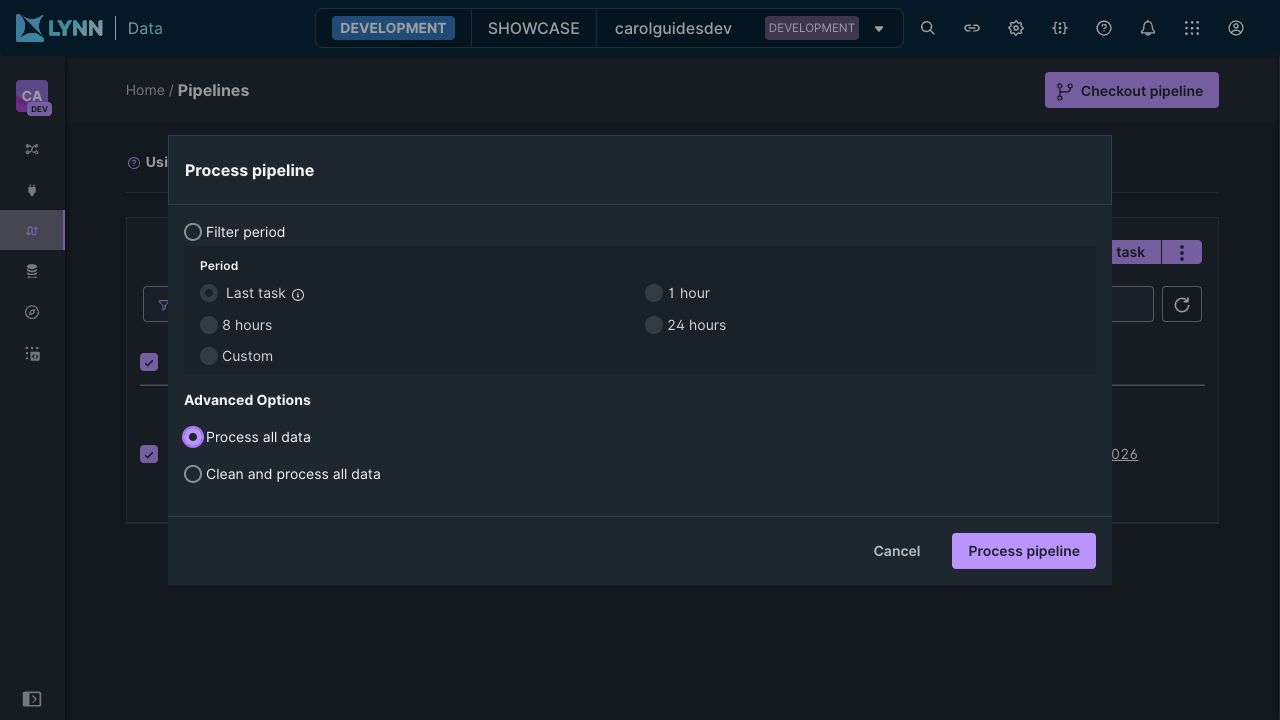
Abra o menu ao lado de Process from last task e escolha Process all data.
-
Confirme em Process pipeline. Cada execução gera uma tarefa, chamada task na Carol. Você pode acompanhá-la por dois caminhos:
- Activity Management: tela com o histórico de tarefas da sua tenant dev. Abra a tarefa da pipeline para consultar o status, os horários e os logs, que são as mensagens da execução
- Last run (última execução): coluna na lista de Pipelines que mostra um resumo da execução mais recente. Clique no status para abrir os detalhes dessa tarefa
Aguarde a conclusão com sucesso antes de conferir os dados
-
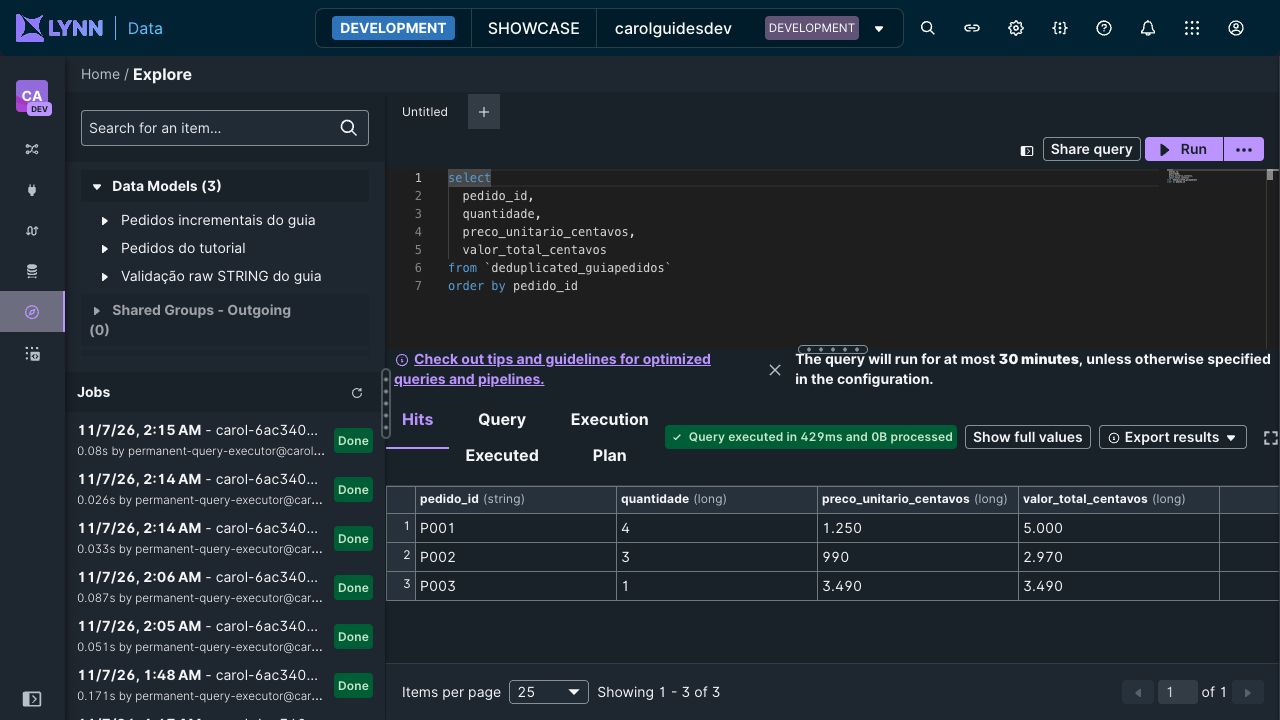
Em connectors → crm_demo → pedidos → Query Editor, execute check-results.sql.
Primeiro resultado esperado:
| Pedido | Quantidade | Preço em centavos | Total em centavos |
|---|---|---|---|
| P001 | 2 | 1250 | 2500 |
| P002 | 3 | 990 | 2970 |
| P003 | 1 | 3490 | 3490 |
Teste a atualização
Reexecute a pipeline: devem continuar três pedidos atuais. Depois envie pedido-atualizado.json pelo endpoint do passo 3.
Confira: P001 com quantidade 4 e valor 5000. Os outros pedidos permanecem iguais.
A consulta usa deduplicated_guiapedidos, que já entrega a versão atual e
desconsidera os registros excluídos. Por isso, não é necessário filtrar mdmDeleted
novamente nessa consulta.
Melhore o desempenho da consulta
Para tabelas maiores, prefira consolidar na query com filtros de partição, evitando
ler toda a tabela. Execute check-results-partitioned.sql no Query Editor
e ajuste o período ao projeto. A coluna padrão é _ingestionDatetime, a data e hora de gravação no BigQuery.
Escolha o período com cuidado: o exemplo usa sete dias. Pedidos sem versões recebidas nessa janela ficam fora da consulta, mesmo que ainda estejam ativos.
Além dos filtros de partição, há técnicas como clustering e análise do plano de execução. Veja quando aplicar cada uma no guia de otimizações em consultas.
Saiba mais: SQL com partição e cuidados de performance
select
  pedido_id,
  quantidade,
  preco_unitario_centavos,
  valor_total_centavos
from `ingestion_guiapedidos`
where _ingestionDatetime >= datetime_sub(current_datetime('UTC'), interval 7 day)
qualify row_number() over (
  partition by mdmId
  order by mdmStagingCounter desc, mdmCounterForEntity desc
) = 1
  and coalesce(mdmDeleted, false) = false
order by pedido_id
A ordem do DM é mdmStagingCounter DESC, depois mdmCounterForEntity DESC.
O teste de mdmDeleted vem após a escolha da versão atual.
A view deduplicated_ pode ler a tabela inteira. O filtro permite ao BigQuery limitar
as partições consultadas. Para manter todo o estado atual com menos consumo, avalie
um incremental ou uma tabela preparada para esse consumo.
Com três pedidos, este ensaio valida a lógica; não mede o ganho de performance de uma base grande.
Passo 6: Agende e acompanhe as execuções
Agende se precisar
Para executar de segunda a sexta às 08h de São Paulo, use o manifest agendado:
{
  "cronExpressions": ["0 0 8 ? * MON-FRI *"],
  "timeZone": "America/Sao_Paulo"
}
O arquivo pipelines.json, usado até aqui, mantém a execução manual. Para aplicar o agendamento à mesma pipeline, troque o manifest no mesmo Carol App:
-
Abra App Config → Git connection e clique em Checkout to another commit ID
-
Selecione um commit que contenha o arquivo
pipelines-scheduled.json -
Em Relative path, substitua o caminho de
pipelines.jsonpelo caminho abaixo, sem/no início:guides/pipelines/first-pipeline/pipelines-scheduled.json -
Confirme em Checkout pipelines e aguarde a conclusão
-
Volte a Pipelines, abra
guia_pedidose confira em Schedule se a agenda indica segunda a sexta às 08h de São Paulo
Depois do checkout, a Carol passa a executar a pipeline automaticamente nos horários configurados. Cada execução utiliza recursos e pode gerar consumo.
O cron usa o padrão Quartz: segundos, minutos, horas, dia do mês, mês, dia da semana e ano (opcional). Use o gerador Quartz do JavaInUse para montar a expressão e conferir sua descrição. Copie o resultado para
cronExpressions.
Acompanhe as execuções
Em Activity Management, abra a task de guia_pedidos para ver o status e os detalhes da execução. Se houver falha, consulte os logs, as mensagens que ajudam a identificar o problema.
Entenda os tempos
| Intervalo | O que significa |
|---|---|
| Criação → Início | Espera até começar o processamento, que pode incluir fila |
| Início → Fim | Processamento dos dados, incluindo a execução do SQL e a gravação do resultado |
| Criação → Fim | Tempo total, somando espera e processamento |
Passo 7: Entenda a cobrança
Esta pipeline usa SQL Processing e BigQuery. O processamento utiliza slots, unidades de capacidade do BigQuery. O consumo considera quantos slots foram usados e por quanto tempo. Os dados armazenados na STG e no DM também geram consumo.
Para fazer uma estimativa mensal:
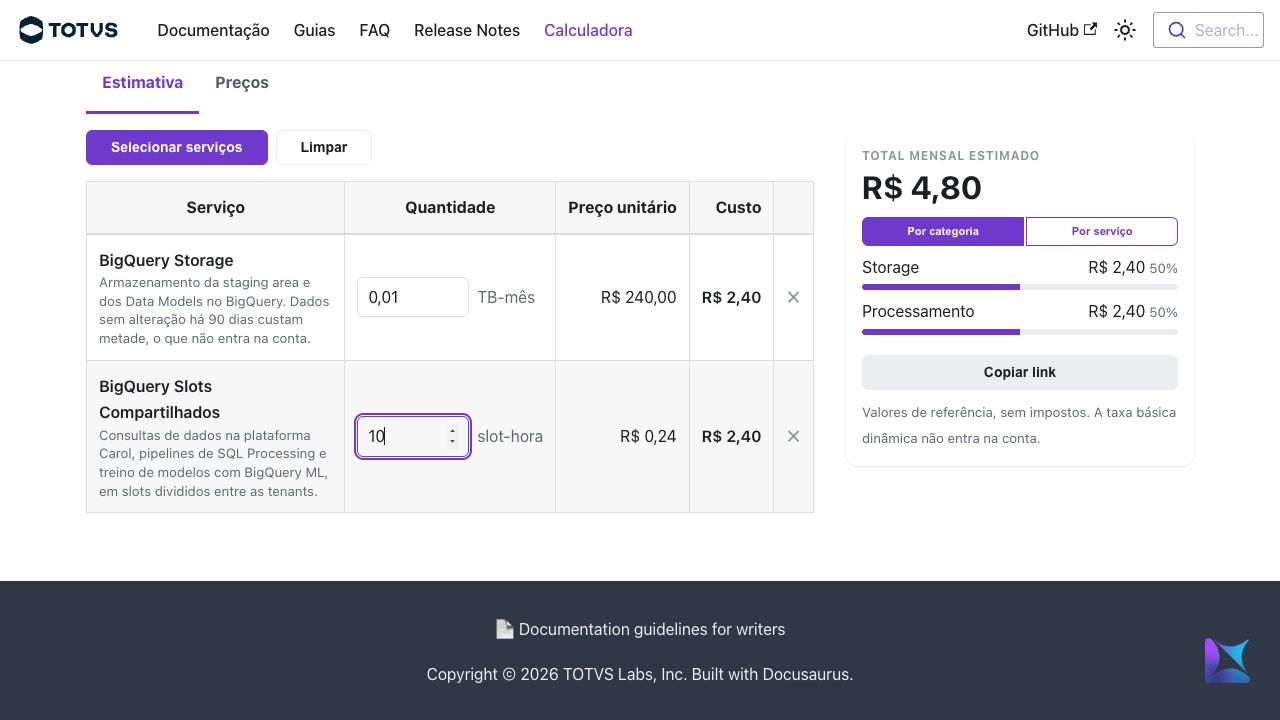
- Abra a calculadora e clique em Selecionar serviços
- Para o processamento, escolha BigQuery Slots Compartilhados ou BigQuery Slots On-Demand, conforme a modalidade usada pela sua tenant dev. Esses serviços representam a capacidade utilizada para executar o SQL
- Adicione BigQuery Storage para estimar o armazenamento. Considere os dados da STG e do DM, incluindo as versões que continuam guardadas
- Preencha Quantidade em cada serviço, respeitando a unidade exibida: slot-hora para processamento e TB-mês para armazenamento. A calculadora multiplica a quantidade pelo preço unitário e mostra o custo estimado
Use o histórico de consumo do projeto como referência, quando disponível. Para o processamento, considere quantas vezes a pipeline será executada no mês. Para o armazenamento, considere o volume médio que ficará guardado nesse período.
O Carol Billing explica os demais componentes da cobrança, como ingestão e rateio dos recursos compartilhados da plataforma. O total da calculadora corresponde aos serviços que você selecionou.
A imagem mostra uma simulação ilustrativa com 10 slot-hora e 0,01 TB-mês, para demonstrar o preenchimento. Esses valores não representam o consumo dos três pedidos do tutorial.
Saiba mais: como preencher o consumo de slots e armazenamento
Slots Compartilhados e Slots On-Demand
Nos Slots Compartilhados, a capacidade de processamento atende várias tenants, e o custo é dividido conforme o uso. Nos Slots On-Demand, nome utilizado no Carol Billing, a capacidade é atribuída à tenant e tem um preço próprio na calculadora. Essa modalidade também possui regras de alocação mínima, detalhadas no Carol Billing.
A modalidade é uma configuração do ambiente. Ao montar a estimativa, selecione o serviço que corresponde ao uso da sua tenant dev.
Como entender slot-hora
Um slot é uma unidade de capacidade que o BigQuery usa para processar sua consulta. Slot-hora mede quanta capacidade foi usada e por quanto tempo.
Veja estes exemplos ilustrativos:
| Capacidade usada | Durante quanto tempo | Consumo |
|---|---|---|
| 1 slot | 1 hora | 1 slot-hora |
| 2 slots | 1 hora | 2 slot-hora |
| 2 slots | 30 minutos | 1 slot-hora |
Na última linha, o dobro de capacidade foi usado pela metade do tempo. Por isso, o consumo é igual ao da primeira linha.
Para estimar o mês, some o consumo das execuções. Por exemplo, 10 execuções de 1 slot-hora cada totalizam 10 slot-hora.
O BigQuery pode variar a quantidade de slots durante uma consulta. Por isso, use o consumo registrado no billing como referência: a duração da task, sozinha, não informa quantos slots foram utilizados.
Como entender TB-mês
TB-mês relaciona o volume armazenado com o período em que ele permanece guardado. Por exemplo, manter uma média de 0,01 TB durante o mês inteiro corresponde a 0,01 TB-mês na estimativa.
Considere o crescimento dos dados e a retenção das versões antigas. Executar a pipeline mais vezes altera o consumo de processamento; manter mais dados guardados altera o consumo de armazenamento.
Dúvidas e problemas comuns
| Situação | O que fazer |
|---|---|
| Os dados enviados não aparecem na STG | Confirme a organização, a tenant dev e o connector ID usados no envio. Confira a chegada dos dados conforme o passo 3 |
| Há várias versões do mesmo pedido na STG | Isso é esperado quando o pedido é atualizado. Para consultar a versão atual, use a consulta do passo 5 |
| A Carol continua usando o código anterior | Envie a alteração ao Git e faça outro checkout, selecionando o novo commit, conforme o passo 4 |
| A pipeline não aparece em Pipelines | Confira o caminho do manifest e se o checkout terminou com sucesso, conforme o passo 4 |
| A execução full manteve versões antigas armazenadas | Full relê os dados da origem. A remoção de versões antigas é feita pela consolidação física |
Para mais detalhes, abra um chamado pelo formulário da Plataforma Carol.
Detalhes
Saiba mais: STG e DM
Tipos de dados
Na STG: recomendamos STRING nos campos de negócio raw, inclusive números e datas. Isso reduz problemas quando uma versão do ERP ou uma mudança no banco de origem altera o formato. Os metadados mantêm os tipos definidos pela Carol.
No DM: os dados já foram tratados e usam os tipos adequados ao negócio. Neste exemplo,
pedido_id continua STRING; quantidade, preço e total usam LONG. Os valores monetários
ficam em centavos. A pipeline converte o texto da STG antes de calcular, preservando a entrada raw.
Chaves e identidade
Na STG: a chave primária, também conhecida como crosswalk, é obrigatória. Neste
exemplo, usamos pedido_id. Quantidade e preço podem mudar e não fazem parte dessa chave.
A Carol gera o mdmId a partir dela para agrupar as versões do mesmo registro.
Veja a relação entre chave, hash e contador no passo 3.
No DM: neste exemplo, a pipeline usa --metadata-v2-- para preservar a identidade
da origem. Assim, as próximas execuções continuam identificando P001 como o mesmo
pedido. Veja os metadados no passo 4 e a consolidação no passo 3.
Configuração e evolução dos campos
Na STG: a opção Flexible, em Options → Data Management, permite criar colunas quando novos atributos chegam na ingestão. Ela ajuda a conhecer uma origem ou acompanhar novos campos de uma integração sem cadastrar cada coluna antecipadamente.
Por exemplo, se um pedido passar a trazer canal: "online", a Carol pode acrescentar
canal ao schema da STG. Continue enviando os valores como texto para manter os campos
raw em STRING.
Defina a chave antes dos envios. O modo flexível não substitui essa definição nem corrige o tipo de uma coluna existente. A criação de colunas exige sincronização com o BigQuery.
Se o envio retornar 409 com Flexible-schema update was triggered, a Carol iniciou
a atualização do schema. Aguarde a sincronização terminar e reenvie o lote, pois esse
retorno ainda não confirma o recebimento dos registros.
Neste tutorial, os três campos já estão definidos e Flexible fica desativado. Veja a referência das staging tables.
No DM: reutilize os campos cadastrados na tenant. As regras de nome, tipo e exclusão estão explicadas na criação das tabelas.
Preencha as descrições dos campos. “Preço unitário em centavos, sem casas decimais” ajuda as pessoas e pode dar contexto a ferramentas de IA que consultem esses metadados no futuro.
Salvar o rascunho não disponibiliza o schema para processamento. Sempre publique após criar ou alterar o DM. O name do DM aceita letras e números; os campos também aceitam underscore.
Veja a referência de data models.
Saiba mais: versões e consolidação dos registros
Consolidação lógica
A consulta escolhe a versão mais recente de cada registro e verifica se ela indica exclusão. Assim, você pode consultar apenas os registros atuais e ativos, enquanto as versões anteriores continuam armazenadas.
Consolidação física
A consolidação física reduz a quantidade de versões armazenadas. Ela segue as regras da tabela e considera o estado mais recente de cada registro, inclusive a indicação de exclusão.
Na STG, essa configuração fica em Options → Data Management → Consolidate records. Habilitar a opção permite que a rotina da plataforma faça a limpeza; com ela desativada, as versões permanecem armazenadas.
Por exemplo, P001 pode ter uma versão com quantidade 2 e outra com quantidade 4. A consulta já pode mostrar apenas a quantidade 4 enquanto as duas versões continuam na STG. Depois, a limpeza física pode remover a versão antiga.
Se a versão mais recente indicar exclusão, uma versão anterior não deve voltar a aparecer como ativa. Por isso, a consulta precisa escolher a versão atual e tratar a exclusão corretamente, antes e depois da limpeza.