Sua primeira pipeline incremental
Versão para revisão.
Este guia é a continuação de Sua primeira pipeline. Na etapa anterior, você criou as tabelas, enviou três pedidos por um endpoint de API REST e calculou seus valores. Depois, reenviou o pedido de código P001 com a quantidade alterada de 2 para 4 unidades. No resultado, o total desse pedido passou de 2500 para 5000 centavos, mantendo apenas sua versão atual.
Agora, a pipeline incremental usará os resultados anteriores para escolher de onde continuar a leitura dos pedidos.
Se a chegada mais recente nos resultados foi às 10h, esse horário será a watermark: a referência para a próxima leitura. Na Carol, ele é representado por um número, o contador. Buscar o maior desses números é o max counter.
Neste guia, a próxima leitura parte da watermark: no exemplo, 10h. O resultado mantém apenas a versão atual de cada pedido.
Você acompanhará a primeira carga, a chegada de alterações e uma reexecução.
Conclua o primeiro guia antes de seguir. Você reaproveitará a tenant dev, o Carol App,
o connector crm_demo, os campos, os tipos e a chave pedido_id.
Neste exercício, usaremos uma nova STG e um novo DM e reenviaremos os pedidos de
exemplo, para comparar as duas pipelines na mesma tenant dev.
Sua jornada em 3 passos
Passo 1: Prepare o exemplo
Use a mesma tenant dev, o Carol App do primeiro guia e o connector crm_demo.
Siga a criação das tabelas do primeiro guia, com os mesmos
campos, tipos e chave pedido_id, alterando apenas os nomes abaixo:
| Recurso | Nome neste exemplo |
|---|---|
| staging table (STG), tabela de dados brutos | pedidos_incrementais |
| data model (DM), tabela de negócio | name guiapedidosincremental, label Pedidos incrementais do guia |
| Pipeline | guia_pedidos_incremental |
Publique o novo DM, mesmo vazio. Ele guardará os resultados e a watermark deste exercício.
Carregue a nova pipeline no mesmo app
Um Carol App pode reunir várias pipelines. O manifest deste exemplo mantém
guia_pedidos e acrescenta guia_pedidos_incremental, reaproveitando o SQL anterior.
- No app do primeiro guia, abra App Config → Git connection e confira o repositório e a branch abaixo
- Clique em Checkout to another commit ID, escolha o commit com estes arquivos e informe o novo caminho do manifest
- Confirme em Checkout pipelines e aguarde. Em Pipelines, confira as duas pipelines vinculadas ao mesmo app
| Conexão | Valor |
|---|---|
| Repositório público | Bruno-Furtado/carolapp-samples |
| Branch de revisão | codex/guides-incremental-pipeline |
| Caminho do manifest | guides/pipelines/incremental-pipeline/pipelines.json |
Durante a revisão, a conexão precisa usar a branch indicada acima. Se ainda estiver na branch do primeiro exemplo, ajuste a configuração Git no app existente antes do checkout.
Passo 2: Aplique o max counter
Vamos manter o cálculo do total dos pedidos, buscar a watermark no DM e usá-la como início da próxima leitura da STG.
Entenda os dois contadores
Os contadores guardam horários como números em microssegundos. O significado depende da tabela:
| Onde | Campo | O que guarda |
|---|---|---|
| STG, onde chegam os pedidos | mdmCounterForEntity | Quando aquela versão do pedido foi recebida pela Carol |
| DM, onde ficam os resultados | mdmStagingCounter | O mesmo horário de recebimento, preservado no resultado |
| DM | mdmCounterForEntity | Quando a pipeline processou aquele resultado |
Por exemplo, P001 chegou às 10h e foi processado às 10h03. Seu
mdmCounterForEntity na STG representa 10h. No DM, o mdmStagingCounter
preserva 10h, enquanto o mdmCounterForEntity representa 10h03.
Usaremos o mdmStagingCounter do DM para calcular a watermark. Assim, a próxima
leitura se orienta pela chegada dos pedidos que geraram os resultados.
O horário de processamento descreve quando a pipeline trabalhou; ele não indica
quando aquela versão chegou à Carol.
1. Busque a watermark no DM
O código completo, pedidos.csql,
mantém o cálculo, o QUALIFY e os metadados do primeiro exemplo. No início dele,
prepare a leitura assim:
declare procedural_pipeline bool default true;

declare max_counter int64 default (
  select coalesce(max(mdmStagingCounter), 0)
  from `ingestion_guiapedidosincremental`
);
procedural_pipeline: deve ser a primeira declaração do script. Informa à Carol que o SQL vai preparar e reutilizar valores em variáveis antes de consultar os pedidos.declare max_counter int64 default (...): cria a variávelmax_counter, que guarda um número inteiro (INT64). Odefaultpreenche essa variável com o resultado da consulta entre parênteses, para usá-lo nos filtros seguintes.max(mdmStagingCounter): consulta os resultados já salvos emingestion_guiapedidosincrementale encontra o maior contador de recebimento. Esse valor é a watermark: a referência para escolher de onde a próxima leitura da STG começa.coalesce(..., 0): na primeira execução, o DM está vazio e oMAXretornaNULL, que significa ausência de valor. OCOALESCEsubstitui essa ausência por zero, permitindo a leitura dos pedidos desde o início. Nas próximas execuções, usa o maior contador encontrado no DM.
2. Leia a STG a partir da watermark
Converta a watermark para data e hora antes do SELECT dos pedidos:
declare partition_start datetime default datetime(timestamp_micros(max_counter));
No SELECT, aplique os dois filtros:
where stg._ingestionDatetime >= partition_start
  and stg.mdmCounterForEntity >= max_counter
mdmCounterForEntityseleciona as versões recebidas a partir da watermark, incluindo as que têm o mesmo contador_ingestionDatetimeindica quando o dado foi gravado no BigQuery. O filtro usa a watermark convertida para limitar as partições que precisam ser lidas
Exemplo com dois pedidos:
- P001 chegou às 10h e seu total já foi calculado. Esse é o recebimento mais recente salvo no DM, então a watermark corresponde a 10h.
- P004 chega às 10h10. Na próxima execução, o filtro lê os pedidos recebidos às 10h ou depois. Ele relê P001 e inclui P004, pois
>=significa “maior ou igual”. - P001 continua sendo o mesmo pedido. A pipeline reconhece sua identidade; a consulta ao resultado mostra apenas sua versão atual. P004 passa a aparecer como um novo pedido.
- A watermark passa para 10h10. Ao salvar o resultado de P004, a Carol preserva seu horário de recebimento em
mdmStagingCounter. Na próxima execução, oMAXencontra esse valor, e a leitura começa às 10h10.
Saiba mais: contador e desempenho
- Use o
mdmStagingCounterdo DM para calcular a watermark. OmdmCounterForEntitydo DM representa o processamento, e não o recebimento na origem _ingestionDatetimeindica a gravação no BigQuery. Seu filtro permite limitar as partições lidas- A leitura começa na watermark, com
overlapDeltaMinutesigual a zero no manifest; não usamos--timestamp--
Confira o plano e os bytes processados. Veja linguagem procedural e as referências do BigQuery para declaração de variáveis e filtros de partição.
Passo 3: Execute e confira
Reutilize o envio por endpoint do primeiro guia,
com o mesmo connectorId, table = pedidos_incrementais e returnData = false.
- Envie o arquivo indicado na tabela e aguarde os registros na STG, sem a tag Showing Table Preview
- Em Pipelines, execute
guia_pedidos_incrementalpor Process from last task - Aguarde a conclusão e confira check-results.sql e check-counter.sql no Query Editor
| Rodada | O que enviar | Resultado esperado |
|---|---|---|
| Primeira carga | pedidos.json | Três pedidos, com P001 em quantidade 2 e total 2500 centavos; o DM passa a ter uma watermark |
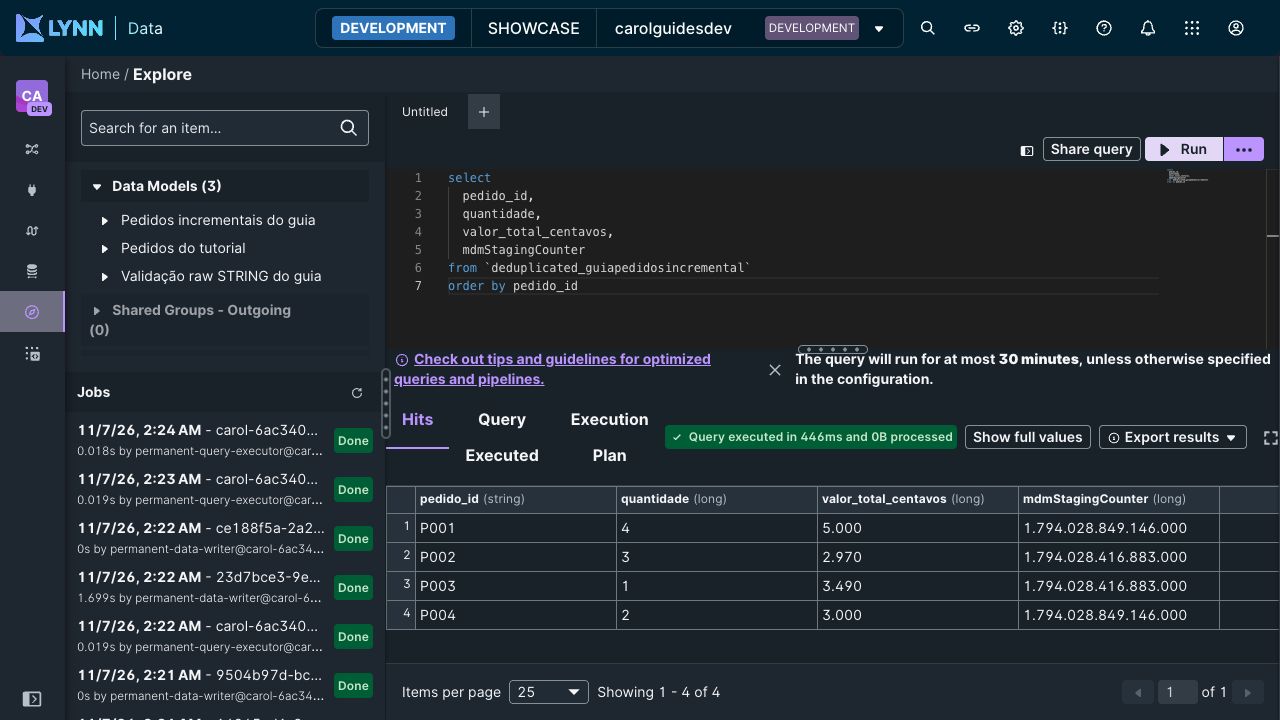
| Atualização | pedidos-atualizados.json | P001 passa a quantidade 4 e total 5000; P004 entra com total 3000; P002 e P003 permanecem; a watermark avança |
| Reexecução | Nenhum novo envio | Os quatro pedidos atuais e a watermark continuam iguais; registros com contador igual à watermark podem ser relidos |
A view deduplicated_ já desconsidera os excluídos, sem precisar repetir o filtro de mdmDeleted.
Para acompanhar a task e o consumo, reutilize monitoramento
e cobrança do primeiro guia.
Saiba mais: teste uma exclusão
-
No Swagger, abra DELETE
/api/v6/staging/intake/tables/{stagingType}/crosswalk/{crosswalkName}. Informe o mesmoconnectorId,stagingType = pedidos_incrementaisecrosswalkName = pedido_id -
Use
returnData = falseeencodedPayload = false. No campo body (corpo da requisição, onde você informa os dados enviados), cole este JSON, disponível em pedido-excluido.json:[
{
"pedido_id": "P002"
}
]- Os colchetes
[]formam a lista de pedidos a excluir; neste teste, ela contém apenas um pedido. pedido_idé a chave que você definiu para identificar cada pedido;P002é o código do pedido que será excluído.- O método DELETE informa a operação de exclusão; o body identifica o pedido. Basta enviar sua chave, sem quantidade ou preço.
- Os colchetes
-
Envie a requisição e aguarde P002 com
mdmDeleted = truena STG. Confira com check-staging.sql. -
Execute a pipeline, aguarde a conclusão e consulte o DM. Devem aparecer P001, P003 e P004, sem P002.
Preserve a exclusão no resultado e no cálculo do MAX: ela também faz parte do progresso.
Não filtre mdmDeleted = false antes do QUALIFY, pois isso poderia recuperar uma versão antiga.
Os conceitos estão em versões e consolidação.
Saiba mais: cuidados ao adaptar para seu projeto
- Mudança na regra: dados com contador anterior à watermark não serão recalculados.
Process all datatambém não remove os filtros escritos no SQL; uma carga completa exige uma consulta própria - Várias fontes: imagine uma adaptação que usa
JOINentre pedidos e produtos para mostrar a categoria do produto em cada pedido. Se apenas a categoria mudar, os pedidos continuam com o mesmo contador. Um filtro que procura novidades só nos pedidos pode deixar os resultados com a categoria antiga. A pipeline precisa também identificar os produtos alterados, encontrar seus pedidos e processar esses pedidos novamente. - Limpeza do destino: a watermark é calculada a partir dos resultados que existem no DM. Imagine que o maior recebimento salvo seja 10h10 e o anterior seja 10h. Se você apagar fisicamente o resultado das 10h10, o
MAXpassará a encontrar 10h, e a próxima execução voltará a ler a partir desse horário. Se apagar todos os resultados, oCOALESCEusará zero e a leitura começará desde o início. Por isso, limpar o DM também altera o ponto de partida da pipeline.